

网站不再单单迎合人类读者。许多站点现在支持一些 API,这些 API 使计算机程序能够获取信息。屏幕抓取 —— 将 HTML 页面解析为更容易理解的表单的省时技术 — 仍然很方便。但使用 API 简化 Web 数据提取的机会在快速增多。根据 ProgrammableWeb 的信息,在本文发表时,已存在 10,000 多个网站 API — 在过去的 15 个月中增加了 3,000 个。(ProgrammableWeb 本身提供了一个 API,可从其目录中搜索和检索 API、mashup、成员概要文件和其他数据。)
本文首先介绍现代的 Web 抓取并将它与 API 方法进行比较。然后通过 Ruby 示例,展示如何使用 API 从一些流行的 Web 属性中提取结构化信息。您需要基本理解 Ruby 语言、具象状态传输 (REST),以及 JavaScript 对象表示法 (JSON) 和 XML 概念。
抓取与 API
现在已有多种抓取解决方案。其中一些将 HTML 转换为其他格式,比如 JSON,这样提取想要的内容会更加简单。其他解决方案读取 HTML,您可将内容定义为 HTML 分层结构的一个函数,其中的数据已加了标记。一种此类解决方案是 Nokogiri,它支持使用 Ruby 语言解析 HTML 和 XML 文档。其他开源抓取工具包括用于 JavaScript 的 pjscrape 和用于 Python 的 Beautiful Soup。pjscrape 实现一个命令行工具来抓取完全呈现的页面,包括 JavaScript 内容。Beautiful Soup 完全集成到 Python 2 和 3 环境中。
假设您希望使用抓取功能和 Nokogiri 来识别 CrunchBase 所报告的 IBM 员工数量。第一步是理解 CrunchBase 上列出了 IBM 员工数量的特定 HTML 页面的标记。图 1 显示了在 Mozilla Firefox 中的 Firebug 工具中打开的此页面。该图的上半部分显示了所呈现的 HTML,下半部分显示了感兴趣部分的 HTML 源代码。
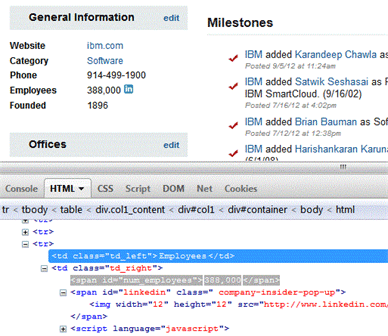
清单 1 中的 Ruby 脚本使用 Nokogiri 从图 1 中的网页抓取员工数量。
清单 1. 使用 Nokogiri 解析 HTML (parse.rb)
#!/usr/bin/env ruby
require 'rubygems'
require 'nokogiri'
require 'open-uri'

# Define the URL with the argument passed by the user
uri = "http://www.crunchbase.com/company/#{ARGV[0]}"

# Use Nokogiri to get the document
doc = Nokogiri::HTML(open(uri))

# Find the link of interest
link = doc.search('tr span[1]')

# Emit the content associated with that link
puts link[0].content
</div>
在 Firebug 显示的 HTML 源代码中(如 图 1 所示),您可看到感兴趣的数据(员工数量)嵌入在一个 HTML 唯一 ID <span> 标记内。还可看到 <span id="num_employees"> 标记是两个 <span> ID 标记中的第一个。所以,清单 1 中的最后两个指令是,使用 link = doc.search('tr span[1]') 请求第一个 <span> 标记,然后使用 puts link[0].content 发出这个已解析链接的内容。
CrunchBase 还公开了一个 REST API,它能够访问的数据比通过抓取功能访问的数据要多得多。清单 2 显示了如何使用该 API 从 CrunchBase 站点提取公司的员工数。
清单 2. 结合使用 CrunchBase REST API 和 JSON 解析 (api.rb)
#!/usr/bin/env ruby
require 'rubygems'
require 'json'
require 'net/http'

# Define the URL with the argument passed by the user
uri = "http://api.crunchbase.com/v/1/company/#{ARGV[0]}.js"

# Perform the HTTP GET request, and return the response
resp = Net::HTTP.get_response(URI.parse(uri))

# Parse the JSON from the response body
jresp = JSON.parse(resp.body)

# Emit the content of interest
puts jresp['number_of_employees']
</div>
在清单 2 中,您定义了一个 URL(公司名称作为脚本参数传入)。然后使用 HTTP 类发出一个 GET 请求并返回响应。响应被解析为一个 JSON 对象,您可通过一个 Ruby 数据结构引用感兴趣的数据项。
清单 3 中的控制台会话显示了运行 清单 1 中的抓取脚本和 清单 2 中基于 API 的脚本的结果。
清单 3. 演示抓取和 API 方法
$ ./parse.rb ibm
388,000
$ ./api.rb ibm
388000
$ ./parse.rb cisco
63,000
$ ./api.rb cisco
63000
$ ./parse.rb paypal
300,000
$ ./api.rb paypal
300000
$
</div>
抓取脚本运行时,您接收一个格式化的计数,而 API 脚本会生成一个原始整数。如清单 3 所示,您可推广每种脚本的使用,从 CrunchBase 跟踪的其他公司请求获得员工数。每种方法提供的 URL 的一般结构使这种通用性成为可能。
那么,我们使用 API 方法能获得什么?对于抓取,您需要分析 HTML 以理解它的结构并识别要提取的数据。然后使用 Nokogiri 解析 HTML 并获取感兴趣的数据就会很简单。但是,如果 HTML 文档的结构发生变化,您可能需要修改脚本才能正确解析新结构。根据 API 契约,API 方法不存在该问题。API 方法的另一个重要优点是,您可访问通过接口(通过返回的 JSON 对象)公开的所有数据。通过 HTML 公开且可供人使用的 CrunchBase 数据要少得多。
现在看看如何使用其他一些 API 从 Internet 提取各类信息,同样要借助 Ruby 脚本。首先看看如何从一个社交网络站点收集个人数据。然后将看到如何通过其他 API 来源查找更少的个人数据。
通过 LinkedIn 提取个人数据
LinkedIn 是一个面向专业职业的社交网络网站。它对联系其他开发人员,寻找工作,研究一家公司,或者加入一个群组,就有趣的主题进行协作很有用。LinkedIn 还整合了一个推荐引擎,可根据您的概要文件推荐工作和公司。
LinkedIn 用户可访问该站点的 REST 和 JavaScript API,从而获取可通过其人类可读网站访问的信息:联系信息、社交分享流、内容群组、通信(消息和联系邀请),以及公司和工作信息。
要使用 LinkedIn API,您必须注册您的应用程序。注册后会获得一个 API 密钥和秘密秘钥,以及一个用户令牌和秘密秘钥。LinkedIn 使用 OAuth 协议进行身份验证。
执行身份验证后,您可通过访问令牌对象发出 REST 请求。响应是一个典型的 HTTP 响应,所以您可将正文解析为 JSON 对象。然后可迭代该 JSON 对象来提取感兴趣的数据。
清单 4 中的 Ruby 脚本为进行身份验证后的 LinkedIn 用户提供了要关注的公司推荐和工作建议。
清单 4. 使用 LinkedIn API (lkdin.rb) 查看公司和工作建议
#!/usr/bin/ruby
require 'rubygems'
require 'oauth'
require 'json'

pquery = "http://api.linkedin.com/v1/people/~?format=json"
cquery='http://api.linkedin.com/v1/people/~/suggestions/to-follow/companies?format=json'
jquery='http://api.linkedin.com/v1/people/~/suggestions/job-suggestions?format=json'

# Fill the keys and secrets you retrieved after registering your app
api_key = 'api key'
api_secret = 'api secret'
user_token = 'user token'
user_secret = 'user secret'

# Specify LinkedIn API endpoint
configuration = { :site => 'https://api.linkedin.com' }

# Use the API key and secret to instantiate consumer object
consumer = OAuth::Consumer.new(api_key, api_secret, configuration)

# Use the developer token and secret to instantiate access token object
access_token = OAuth::AccessToken.new(consumer, user_token, user_secret)

# Get the username for this profile
response = access_token.get(pquery)
jresp = JSON.parse(response.body)
myName = "#{jresp['firstName']} #{jresp['lastName']}"
puts "\nSuggested companies to follow for #{myName}"

# Get the suggested companies to follow
response = access_token.get(cquery)
jresp = JSON.parse(response.body)

# Iterate through each and display the company name
jresp['values'].each do | company |
  puts " #{company['name']}"
end

# Get the job suggestions
response = access_token.get(jquery)
jresp = JSON.parse(response.body)
puts "\nSuggested jobs for #{myName}"

# Iterate through each suggested job and print the company name
jresp['jobs']['values'].each do | job |
  puts " #{job['company']['name']} in #{job['locationDescription']}"
end

puts "\n"
</div>
清单 5 中的控制台会话显示了运行 清单 4 中的 Ruby 脚本的输出。脚本中对 LinkedIn API 的 3 次独立调用有不同的输出结果(一个用于身份验证,其他两个分别用于公司建议和工作建议链接)。
清单 5. 演示 LinkedIn Ruby 脚本
$ ./lkdin.rb Suggested companies to follow for M. Tim Jones Open Kernel Labs, Inc. Linaro Wind River DDC-I Linsyssoft Technologies Kalray American Megatrends JetHead Development Evidence Srl Aizyc Technology Suggested jobs for M. Tim Jones Kozio in Greater Denver Area Samsung Semiconductor Inc in San Jose, CA Terran Systems in Sunnyvale, CA Magnum Semiconductor in San Franc