

一、基本概念
查找(Searching)就是根据给定的某个值,在查找表中确定一个其关键字等于给定值的数据元素(或记录)。
查找表(Search Table):由同一类型的数据元素(或记录)构成的集合
关键字(Key):数据元素中某个数据项的值,又称为键值。
主键(Primary Key):可唯一地标识某个数据元素或记录的关键字。
查找表按照操作方式可分为:
- 静态查找表(Static Search Table):只做查找操作的查找表。它的主要操作是:
- 查询某个“特定的”数据元素是否在表中
- 检索某个“特定的”数据元素和各种属性
- 动态查找表(Dynamic Search Table):在查找中同时进行插入或删除等操作:
- 查找时插入数据
- 查找时删除数据
二、无序表查找
也就是数据不排序的线性查找,遍历数据元素。
算法分析:最好情况是在第一个位置就找到了,此为O(1);最坏情况在最后一个位置才找到,此为O(n);所以平均查找次数为(n+1)/2。最终时间复杂度为O(n)
# 最基础的遍历无序列表的查找算法
# 时间复杂度O(n)

def sequential_search(lis, key):
  length = len(lis)
  for i in range(length):
    if lis[i] == key:
      return i
    else:
      return False


if __name__ == '__main__':
  LIST = [1, 5, 8, 123, 22, 54, 7, 99, 300, 222]
  result = sequential_search(LIST, 123)
  print(result)
</div>
三、有序表查找
查找表中的数据必须按某个主键进行某种排序!
1. 二分查找(Binary Search)
算法核心:在查找表中不断取中间元素与查找值进行比较,以二分之一的倍率进行表范围的缩小。
# 针对有序查找表的二分查找算法
# 时间复杂度O(log(n))

def binary_search(lis, key):
  low = 0
  high = len(lis) - 1
  time = 0
  while low < high:
    time += 1
    mid = int((low + high) / 2)
    if key < lis[mid]:
      high = mid - 1
    elif key > lis[mid]:
      low = mid + 1
    else:
      # 打印折半的次数
      print("times: %s" % time)
      return mid
  print("times: %s" % time)
  return False

if __name__ == '__main__':
  LIST = [1, 5, 7, 8, 22, 54, 99, 123, 200, 222, 444]
  result = binary_search(LIST, 99)
  print(result)
</div>
2. 插值查找
二分查找法虽然已经很不错了,但还有可以优化的地方。
有的时候,对半过滤还不够狠,要是每次都排除十分之九的数据岂不是更好?选择这个值就是关键问题,插值的意义就是:以更快的速度进行缩减。
插值的核心就是使用公式:
value = (key - list[low])/(list[high] - list[low])
用这个value来代替二分查找中的1/2。
上面的代码可以直接使用,只需要改一句。
# 插值查找算法
# 时间复杂度O(log(n))

def binary_search(lis, key):
  low = 0
  high = len(lis) - 1
  time = 0
  while low < high:
    time += 1
    # 计算mid值是插值算法的核心代码
    mid = low + int((high - low) * (key - lis[low])/(lis[high] - lis[low]))
    print("mid=%s, low=%s, high=%s" % (mid, low, high))
    if key < lis[mid]:
      high = mid - 1
    elif key > lis[mid]:
      low = mid + 1
    else:
      # 打印查找的次数
      print("times: %s" % time)
      return mid
  print("times: %s" % time)
  return False

if __name__ == '__main__':
  LIST = [1, 5, 7, 8, 22, 54, 99, 123, 200, 222, 444]
  result = binary_search(LIST, 444)
  print(result)
</div>
插值算法的总体时间复杂度仍然属于O(log(n))级别的。其优点是,对于表内数据量较大,且关键字分布比较均匀的查找表,使用插值算法的平均性能比二分查找要好得多。反之,对于分布极端不均匀的数据,则不适合使用插值算法。
3. 斐波那契查找
由插值算法带来的启发,发明了斐波那契算法。其核心也是如何优化那个缩减速率,使得查找次数尽量降低。
使用这种算法,前提是已经有一个包含斐波那契数据的列表
F = [1, 1, 2, 3, 5, 8, 13, 21, 34, 55, 89, 144,...]
# 斐波那契查找算法
# 时间复杂度O(log(n))

def fibonacci_search(lis, key):
  # 需要一个现成的斐波那契列表。其最大元素的值必须超过查找表中元素个数的数值。
  F = [1, 1, 2, 3, 5, 8, 13, 21, 34, 55, 89, 144,
     233, 377, 610, 987, 1597, 2584, 4181, 6765,
     10946, 17711, 28657, 46368]
  low = 0
  high = len(lis) - 1

  # 为了使得查找表满足斐波那契特性,在表的最后添加几个同样的值
  # 这个值是原查找表的最后那个元素的值
  # 添加的个数由F[k]-1-high决定
  k = 0
  while high > F[k]-1:
    k += 1
  print(k)
  i = high
  while F[k]-1 > i:
    lis.append(lis[high])
    i += 1
  print(lis)

  # 算法主逻辑。time用于展示循环的次数。
  time = 0
  while low <= high:
    time += 1
    # 为了防止F列表下标溢出,设置if和else
    if k < 2:
      mid = low
    else:
      mid = low + F[k-1]-1

    print("low=%s, mid=%s, high=%s" % (low, mid, high))
    if key < lis[mid]:
      high = mid - 1
      k -= 1
    elif key > lis[mid]:
      low = mid + 1
      k -= 2
    else:
      if mid <= high:
        # 打印查找的次数
        print("times: %s" % time)
        return mid
      else:
        print("times: %s" % time)
        return high
  print("times: %s" % time)
  return False

if __name__ == '__main__':
  LIST = [1, 5, 7, 8, 22, 54, 99, 123, 200, 222, 444]
  result = fibonacci_search(LIST, 444)
  print(result)
</div>
算法分析:斐波那契查找的整体时间复杂度也为O(log(n))。但就平均性能,要优于二分查找。但是在最坏情况下,比如这里如果key为1,则始终处于左侧半区查找,此时其效率要低于二分查找。
总结:二分查找的mid运算是加法与除法,插值查找则是复杂的四则运算,而斐波那契查找只是最简单的加减运算。在海量数据的查找中,这种细微的差别可能会影响最终的查找效率。因此,三种有序表的查找方法本质上是分割点的选择不同,各有优劣,应根据实际情况进行选择。
四、线性索引查找
对于海量的无序数据,为了提高查找速度,一般会为其构造索引表。
索引就是把一个关键字与它相对应的记录进行关联的过程。
一个索引由若干个索引项构成,每个索引项至少包含关键字和其对应的记录在存储器中的位置等信息。
索引按照结构可以分为:线性索引、树形索引和多级索引。
线性索引:将索引项的集合通过线性结构来组织,也叫索引表。
线性索引可分为:稠密索引、分块索引和倒排索引
1.稠密索引
稠密索引指的是在线性索引中,为数据集合中的每个记录都建立一个索引项。
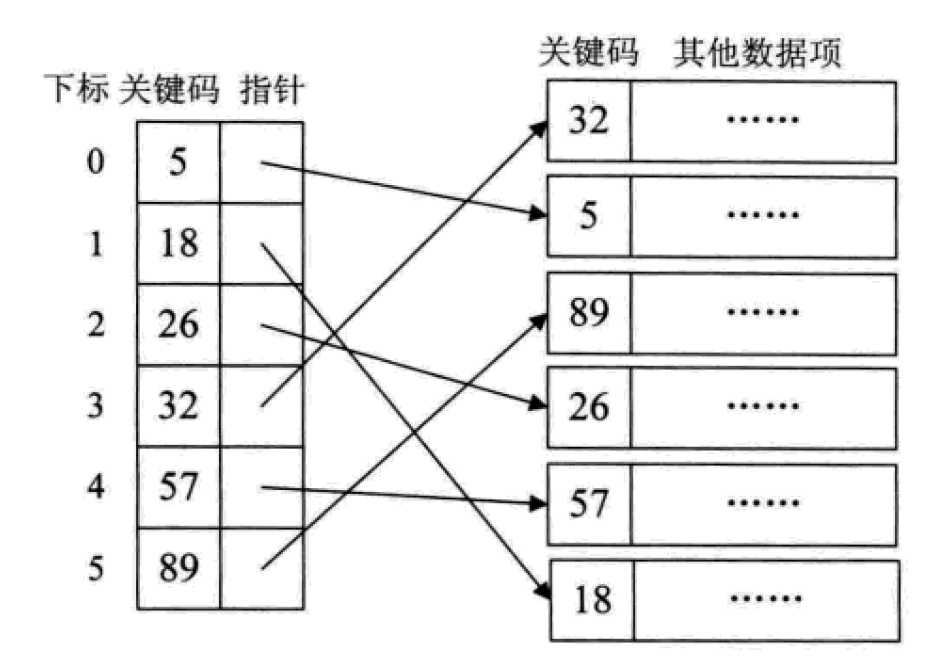
这其实就相当于给无序的集合,建立了一张有序的线性表。其索引项一定是按照关键码进行有序的排列。
这也相当于把查找过程中需要的排序工作给提前做了。
1.分块索引
给大量的无序数据集合进行分块处理,使得块内无序,块与块之间有序。
这其实是有序查找和无序查找的一种中间状态或者说妥协状态。因为数据量过大,建立完整的稠密索引耗时耗力,占用资源过多;但如果不做任何排序或者索引,那么遍历的查找也无法接受,只能折中,做一定程度的排序或索引。
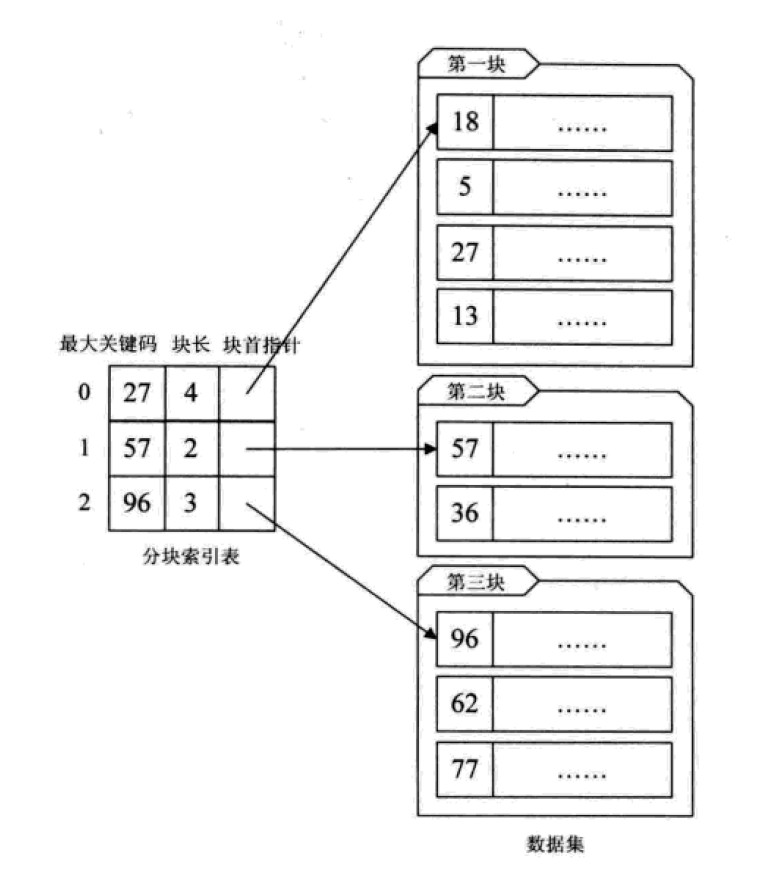
分块索引的效率比遍历查找的O(n)要高一些,但与二分查找的O(logn)还是要差不少。
1.倒排索引
不是由记录来确定属性值,而是由属性值来确定记录的位置,这种被称为倒排索引。其中记录号表存储具有相同次关键字的所有记录的地址或引用(可以是指向记录的指针或该记录的主关键字)。
倒排索引是最基础的搜索引擎索引技术。
五、二叉排序树
二叉排序树又称为二叉查找树。它或者是一颗空树,或者是具有下列性质的二叉树:
- 若它的左子树不为空,则左子树上所有节点的值均小于它的根结构的值;
- 若它的右子树不为空,则右子树上所有节点的值均大于它的根结构的值;
- 它的左、右子树也分别为二叉排序树。
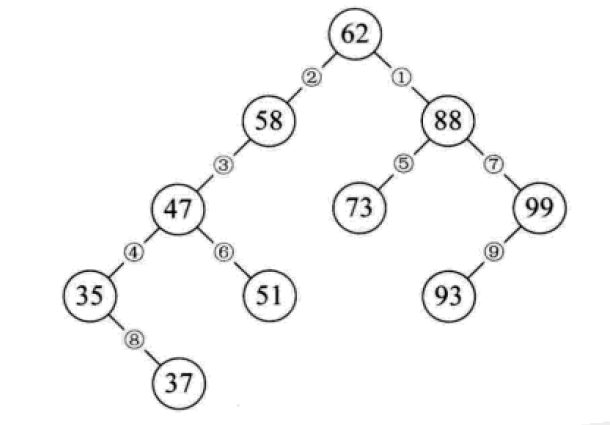
构造一颗二叉排序树的目的,往往不是为了排序,而是为了提高查找和插入删除关键字的速度。
二叉排序树的操作: