

你是否苦恼于网上无法下载的“小说在线阅读”内容?或是某些文章的内容让你很有收藏的冲动,却找不到一个下载的链接?是不是有种自己写个程序把全部搞定的冲动?是不是学了 python,想要找点东西大展拳脚,告诉别人“哥可是很牛逼的!”?那就让我们开始吧! 哈哈~
好吧,我就是最近写 Yii 写多了,想找点东西调剂一下.... = =
本项目以研究为目的,所有版权问题我们都是站在作者的一边,以看盗版小说为目的的读者们请自行面壁!
说了这么多,我们要做的就是把小说正文的内容从网页上爬下来,我们的研究对象是全本小说网....再次声明,不对任何版权负责....
一开始先做最基础的内容,就是把某一章的内容抓取下来。
环境:Ubuntu, Python 2.7
基础知识
这个程序涉及到的知识点有几个,在这里列出来,不详细讲,有疑问的直接百度会有一堆的。
1.urllib2 模块的 request 对像来设置 HTTP 请求,包括抓取的 url,和伪装浏览器的代理。然后就是 urlopen 和 read 方法,都很好理解。
2.chardet 模块,用于检测网页的编码。在网页上抓取数据很容易遇到乱码的问题,为了判断网页是 gtk 编码还是 utf-8 ,所以用 chardet 的 detect 函数进行检测。在用 Windows 的同学可以在这里 http://download.csdn.net/detail/jcjc918/8231371 下载,解压到 python 的 lib 目录下就好。
3. decode 函数将字符串从某种编码转为 unicode 字符,而 encode 把 unicode 字符转为指定编码格式的字符串。
4. re 模块正则表达式的应用。search 函数可以找到和正则表达式对应匹配的一项,而 replace 则是把匹配到的字符串替换。
思路分析:
我们选取的 url 是 http://www.quanben.com/xiaoshuo/0/910/59302.html,斗罗大陆的第一章。你可以查看网页的源代码,会发现只有一个 content 标签包含了所有章节的内容,所以可以用正则把 content 的标签匹配到,抓取下来。试着把这一部分内容打印出来,会发现很多 <br /> 和 ,<br /> 要替换成换行符, 是网页中的占位符,即空格,替换成空格就好。这样一章的内容就很美观的出来了。完整起见,同样用正则把标题爬下来。
程序
# -*- coding: utf-8 -*-

import urllib2
import re
import chardet


class Book_Spider:

  def __init__(self):
    self.pages = []

  # 抓取一个章节
  def GetPage(self):
    myUrl = "http://www.quanben.com/xiaoshuo/0/910/59302.html";
    user_agent = 'Mozilla/4.0 (compatible; MSIE 5.5; Windows NT)'
    headers = { 'User-Agent' : user_agent }
    request = urllib2.Request(myUrl, headers = headers)
    myResponse = urllib2.urlopen(request)
    myPage = myResponse.read()

    #先检测网页的字符编码,最后统一转为 utf-8
    charset = chardet.detect(myPage)
    charset = charset['encoding']
    if charset == 'utf-8' or charset == 'UTF-8':
      myPage = myPage
    else:
      myPage = myPage.decode('gb2312','ignore').encode('utf-8')
    unicodePage = myPage.decode("utf-8")

    try:
      #抓取标题
      my_title = re.search('<h1>(.*?)</h1>',unicodePage,re.S)
      my_title = my_title.group(1)
    except:
      print '标题 HTML 变化,请重新分析!'
      return False

    try:
      #抓取章节内容
      my_content = re.search('<div.*?id="htmlContent" class="contentbox">(.*?)<div',unicodePage,re.S)
      my_content = my_content.group(1)
    except:
      print "内容 HTML 变化,请重新分析!"
      return False

    #替换正文中的网页代码
    my_content = my_content.replace("<br />","\n")
    my_content = my_content.replace(" "," ")

    #用字典存储一章的标题和内容
    onePage = {'title':my_title,'content':my_content}
    return onePage


  # 用于加载章节
  def LoadPage(self):
    try:
      # 获取新的章节
      myPage = self.GetPage()

      if myPage == False:
        print '抓取失败!'
        return False

      self.pages.append(myPage)
    except:
      print '无法连接服务器!'

  #显示一章
  def ShowPage(self,curPage):
      print curPage['title']
      print curPage['content']

  def Start(self):
    print u'开始阅读......\n'
    #把这一页加载进来
    self.LoadPage()
    # 如果self的pages数组中存有元素
    if self.pages:
      nowPage = self.pages[0]
      self.ShowPage(nowPage)


#----------- 程序的入口处 -----------
print u"""
---------------------------------------
  程序:阅读呼叫转移
  版本:0.1
  作者:angryrookie
  日期:2014-07-05
  语言:Python 2.7
  功能:按下回车浏览章节
---------------------------------------
"""

print u'请按下回车:'
raw_input()
myBook = Book_Spider()
myBook.Start()
</div>
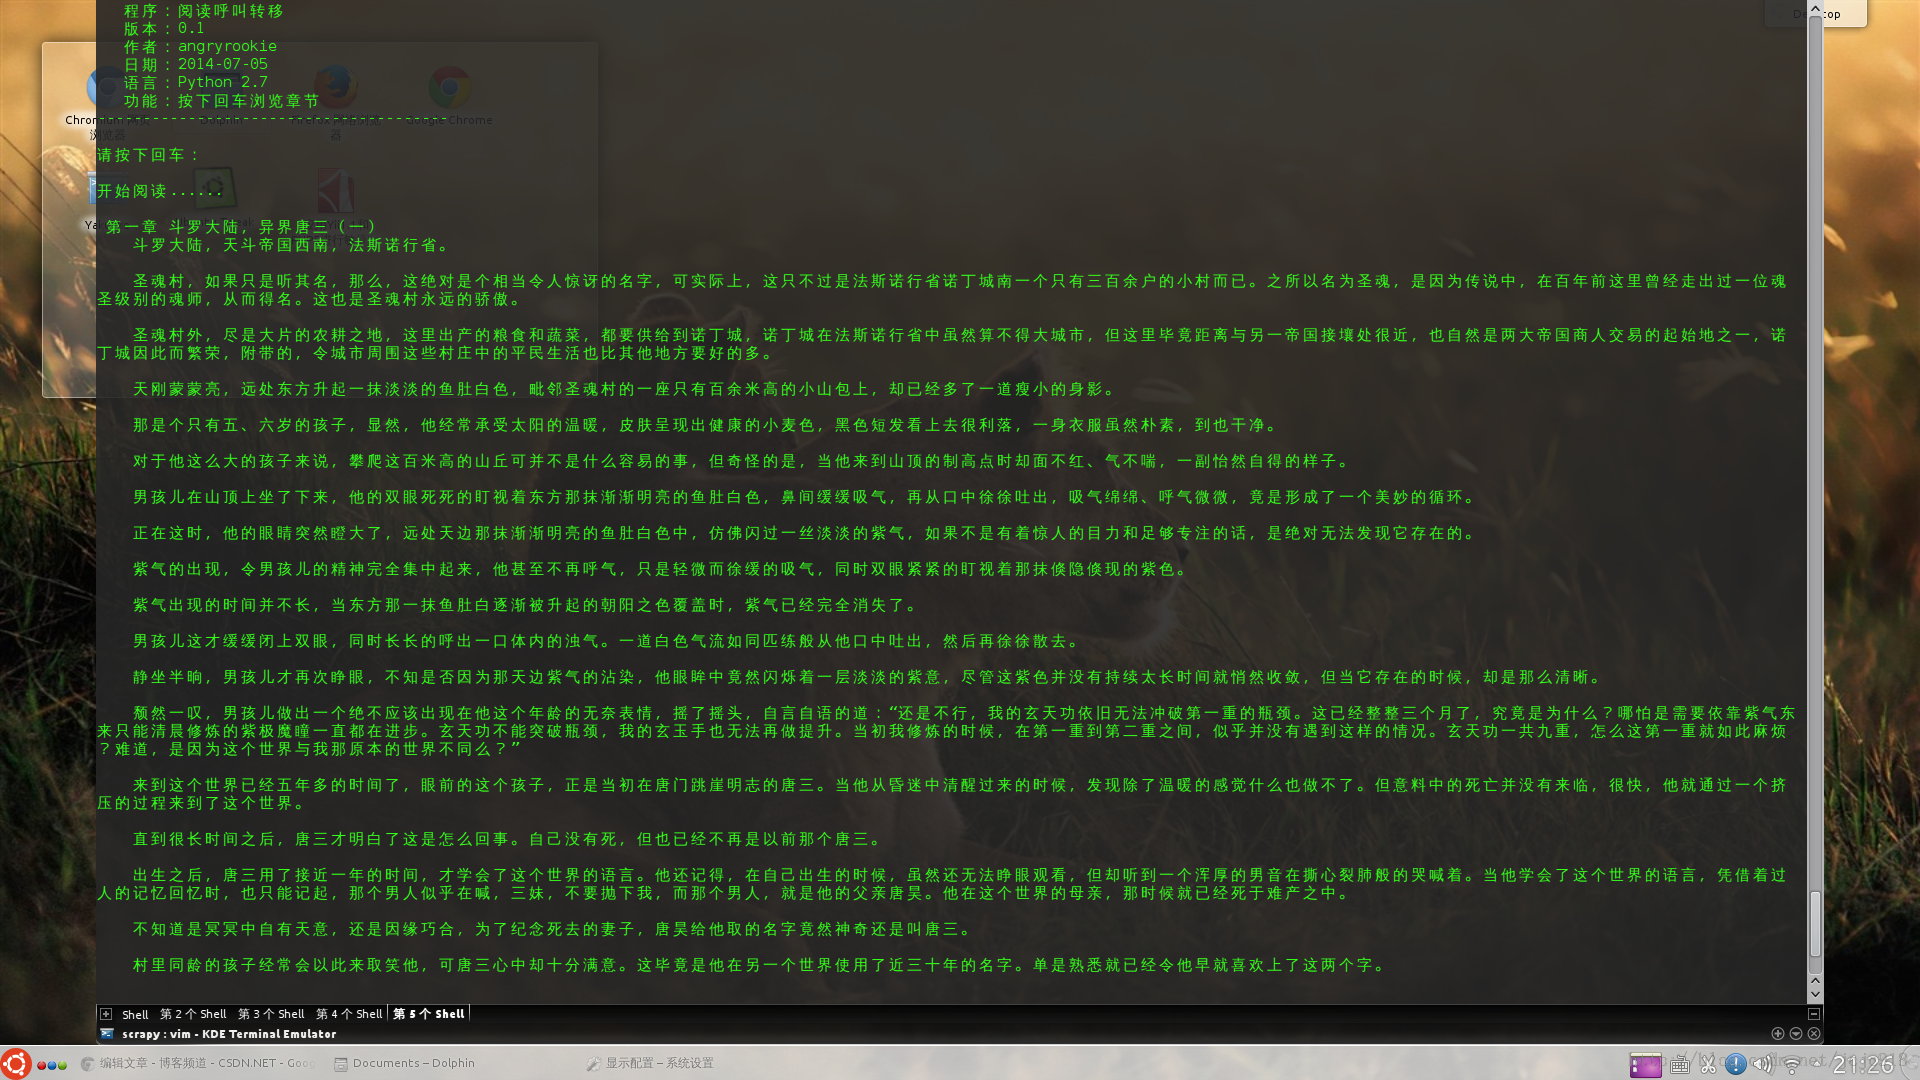
程序运行完在我这里可是很好看的,不信请看:^_^
理所当然地,接下来我们要把整本小说都爬下来。首先,我们要把程序从原来的读完一章就结束,改成读完一章之后可以继续进行下一章的阅读。
注意到每个小说章节的网页下面都有下一页的链接。通过查看网页源代码,稍微整理一下( 不显示了),我们可以看到这一部分的 HTML 是下面这种格式的:
<div id="footlink">
 <script type="text/javascript" charset="utf-8" src="/scripts/style5.js"></script>
 <a href="http://www.quanben.com/xiaoshuo/0/910/59301.html">上一页</a>
 <a href="http://www.quanben.com/xiaoshuo/0/910/">返回目录</a>
 <a href="http://www.quanben.com/xiaoshuo/0/910/59303.html">下一页</a>
</div>
</div>
上一页 、返回目录、下一页都在一个 id 为 footlink 的 div 中,如果想要对每个链接进行匹配的话,会抓取到网页上大量的其他链接,但是 footlink 的 div 只有一个啊!我们可以把这个 div 匹配到,抓下来,然后在这个抓下来的 div 里面再匹配 <a> 的链接,这时就只有三个了。只要取最后一个链接就是下一页的 url 的,用这个 url 更新我们抓取的目标 url ,这样就能一直抓到下一页。用户阅读逻辑为每读一个章节后,等待用户输入,如果是 quit 则退出程序,否则显示下一章。
基础知识:
上一篇的基础知识加上 Python 的 thread 模块.
源代码:
# -*- coding: utf-8 -*-
import urllib2
import re
import thread
import chardet
class Book_Spider:
def __init__(self):
self.pages = []
self.page = 1
self.flag = True
self.url = "http://www.quanben.com/xiaoshuo/10/10412/2095096.html"
# 将抓取一个章节
def GetPage(self):
myUrl = self.url
user_agent = 'Mozilla/4.0 (compatible; MSIE 5.5; Windows NT)'
headers = { 'User-Agent' : user_agent }
req = urllib2.Request(myUrl, headers = headers)
myResponse = urllib2.urlopen(req)
myPage = myResponse.read()
charset = chardet.detect(myPage)
charset = charset['encoding']
if charset == 'utf-8' or charset == 'UTF-8':
myPage = myPage
else:
myPage = myPage.decode('gb2312','ignore').encode('utf-8')
unicodePage = myPage.decode("utf-8")
# 找出 id="content"的div标记
try:
#抓取标题
my_title = re.search('<h1>(.*?)</h1>',unicodePage,re.S)
my_title = my_title.group(1)
except:
print '标题 HTML 变化,请重新分析!'
return False
try:
#抓取章节内容
my_content = re.search('<div.*?id="htmlContent" class="contentbox">(.*?)<div',unicodePage,re.S)
my_content = my_content.group(1)
except:
print "内容 HTML 变化,请重新分析!"
return False
my_content = my_content.replace("<br />","\n")
my_content = my_content.replace(" "," ")
#用