

(一)什么是json:
JSON(JavaScript Object Notation) 是一种轻量级的数据交换格式。易于人阅读和编写。同时也易于机器解析和生成。它基于JavaScript Programming Language, Standard ECMA-262 3rd Edition - December 1999的一个子集。JSON采用完全独立于语言的文本格式,但是也使用了类似于C语言家族的习惯(包括C, C++, C#, Java, JavaScript, Perl, Python等)。这些特性使JSON成为理想的数据交换语言。
JSON建构于两种结构:
“名称/值”对的集合(A collection of name/value pairs)。不同的语言中,它被理解为对象(object),纪录(record),结构(struct),字典(dictionary),哈希表(hash table),有键列表(keyed list),或者关联数组 (associative array)。
值的有序列表(An ordered list of values)。在大部分语言中,它被理解为数组(array)。
这些都是常见的数据结构。事实上大部分现代计算机语言都以某种形式支持它们。这使得一种数据格式在同样基于这些结构的编程语言之间交换成为可能。
(二)Python JSON模块
Python2.6开始加入了JSON模块,无需另外下载,Python的Json模块序列化与反序列化的过程分别是 encoding和 decoding。encoding-把一个Python对象编码转换成Json字符串;decoding-把Json格式字符串解码转换成Python对象。要使用json模块必须先导入:
import json</div>
1,简单数据类型的处理
Python JSON模块可以直接处理简单数据类型(string、unicode、int、float、list、tuple、dict)。 json.dumps()方法返回一个str对象,编码过程中会存在从python原始类型向json类型的转化过程,具体的转化对照如下:
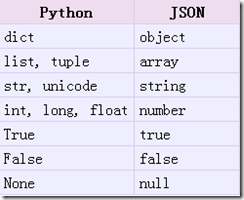
json.dumps方法提供了很多好用的参数可供选择,比较常用的有sort_keys(对dict对象进行排序,我们知道默认dict是无序存放的)、separators,indent等参数,dumps方法的定义为:
json.dump(obj, fp, skipkeys=False, ensure_ascii=True, check_circular=True, allow_nan=True,cls=None, indent=None, separators=None, encoding="utf-8", default=None, sort_keys=False,**kw)</div>
使用简单的json.dumps方法对简单数据类型进行编码,例如:
obj = [[1,2,3],123,123.123,'abc',{'key1':(1,2,3),'key2':(4,5,6)}]
encodedjson = json.dumps(obj)
print 'the original list:\n',obj
print 'length of obj is:',len(repr(obj))
print 'repr(obj),replace whiteblank with *:\n', repr(obj).replace(' ','*')
print 'json encoded,replace whiteblank with *:\n',encodedjson.replace(' ','*')
</div>
输出:(Python默认的item separator是‘, '(不是','),所以list无论是转化成字符串还是json格式,成员之间都是有空格隔开的)
the original list:
[[1, 2, 3], 123, 123.123, 'abc', {'key2': (4, 5, 6), 'key1': (1, 2, 3)}]
length of obj is: 72
repr(obj),replace whiteblank with *:
[[1,*2,*3],*123,*123.123,*'abc',*{'key2':*(4,*5,*6),*'key1':*(1,*2,*3)}]
json encoded,replace whiteblank with *:
[[1,*2,*3],*123,*123.123,*"abc",*{"key2":*[4,*5,*6],*"key1":*[1,*2,*3]}]
<type 'list'>
</div>
我们接下来在对encodedjson进行decode,得到原始数据,需要使用的json.loads()函数。loads方法返回了原始的对象,但是仍然发生了一些数据类型的转化,上例中‘abc'转化为了unicode类型。需要注意的是,json字符串中的字典类型的key必须要用双引号“”json.loads()才能正常解析。从json到python的类型转化对照如下:
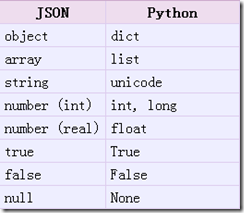
decodejson = json.loads(encodedjson)
print 'the type of decodeed obj from json:', type(decodejson)
print 'the obj is:\n',decodejson
print 'length of decoded obj is:',len(repr(decodejson))
</div>
输出:
the type of decodeed obj from json: <type 'list'>
the obj is:
[[1, 2, 3], 123, 123.123, u'abc', {u'key2': [4, 5, 6], u'key1': [1, 2, 3]}]
length of decoded obj is: 75 #比原obj多出了3个unicode编码标示‘u'
</div>
sort_keys排序功能使得存储的数据更加有利于观察,也使得对json输出的对象进行比较。下例中,data1和data2数据应该是一样的,dict存储的无序性造成两者无法比较。
data1 = {'b':789,'c':456,'a':123}
data2 = {'a':123,'b':789,'c':456}
d1 = json.dumps(data1,sort_keys=True)
d2 = json.dumps(data2)
d3 = json.dumps(data2,sort_keys=True)
print 'sorted data1(d1):',d1
print 'unsorted data2(d2):',d2
print 'sorted data2(d3):',d3
print 'd1==d2?:',d1==d2
print 'd1==d3?:',d1==d3
</div>
输出:
sorted data1(d1): {"a": 123, "b": 789, "c": 456}
unsorted data2(d2): {"a": 123, "c": 456, "b": 789}
sorted data2(d3): {"a": 123, "b": 789, "c": 456}
d1==d2?: False
d1==d3?: True
</div>
indent参数是缩进的意思,它可以使数据的存储格式更优雅、可读性更强,这是通过增加一些冗余的空格进行填充的。但是在解码(json.loads())时,空白填充会被删除。
data = {'b':789,'c':456,'a':123}
d1 = json.dumps(data,sort_keys=True,indent=4)
print 'data len is:',len(repr(data))
print '4 indented data:\n',d1
d2 = json.loads(d1)
print 'decoded DATA:', repr(d2)
print 'len of decoded DATA:',len(repr(d2))
</div>
输出:(可见loads时会将dumps时增加的intent 填充空格去除)
data len is: 30
4 indented data:
{
  "a": 123,
  "b": 789,
  "c": 456
}
decoded DATA: {u'a': 123, u'c': 456, u'b': 789}
len of decoded DATA: 33
</div>
json主要是作为一种数据通信的格式存在的,无用的空格会浪费通信带宽,适当时候也要对数据进行压缩。separator参数可以起到这样的作用,该参数传递是一个元组,包含分割对象的字符串,其实质就是将Python默认的(‘, ',': ')分隔符替换成(',',':')。
data = {'b':789,'c':456,'a':123}
print 'DATA:', repr(data)
print 'repr(data)       :', len(repr(data))
print 'dumps(data)      :', len(json.dumps(data))
print 'dumps(data, indent=2) :', len(json.dumps(data, indent=4))
print 'dumps(data, separators):', len(json.dumps(data, separators=(',',':')))
</div>
输出:
DATA: {'a': 123, 'c': 456, 'b': 789}
repr(data)       : 30
dumps(data)      : 30
dumps(data, indent=2) : 46
dumps(data, separators): 25
</div>
另一个比较有用的dumps参数是skipkeys,默认为False。 dumps方法存储dict对象时key必须是str类型,其他类型会导致TypeError异常产生,如果将skipkeys设为True则会优雅的滤除非法keys。
data = {'b':789,'c':456,(1,2):123}
print'original data:',repr(data)
print 'json encoded',json.dumps(data,skipkeys=True)
</div>
输出:
original data: {(1, 2): 123, 'c': 456, 'b': 789}
json encoded {"c": 456, "b": 789}
</div>
2,JSON处理自定义数据类型
json模块不仅可以处理普通的python内置类型,也可以处理我们自定义的数据类型,而往往处理自定义的对象是很常用的。
如果直接通过json.dumps方法对Person的实例进行处理的话,会报错,因为json无法支持这样的自动转化。通过上面所提到的json和 python的类型转化对照表,可以发现,object类型是和dict相关联的,所以我们需要把我们自定义的类型转化为dict,然后再进行处理。这里,有两种方法可以使用。
方法一:自己写转化函数
自定义object类型和dict类型进行转化:encode-定义函数 object2dict()将对象模块名、类名以及__dict__存储在一个字典并返回;decode-定义d