

网络爬虫,是在网上进行数据抓取的程序,使用它能够抓取特定网页的HTML数据。虽然我们利用一些库开发一个爬虫程序,但是使用框架可以大大提高效率,缩短开发时间。Scrapy是一个使用Python编写的,轻量级的,简单轻巧,并且使用起来非常的方便。使用Scrapy可以很方便的完成网上数据的采集工作,它为我们完成了大量的工作,而不需要自己费大力气去开发。
首先先要回答一个问题。
问:把网站装进爬虫里,总共分几步?
答案很简单,四步:
新建项目 (Project):新建一个新的爬虫项目
明确目标(Items):明确你想要抓取的目标
制作爬虫(Spider):制作爬虫开始爬取网页
存储内容(Pipeline):设计管道存储爬取内容
好的,基本流程既然确定了,那接下来就一步一步的完成就可以了。
1.新建项目(Project)
在空目录下按住Shift键右击,选择“在此处打开命令窗口”,输入一下命令:
scrapy startproject tutorial
</div>
其中,tutorial为项目名称。
可以看到将会创建一个tutorial文件夹,目录结构如下:
tutorial/
scrapy.cfg
tutorial/
__init__.py
items.py
pipelines.py
settings.py
spiders/
__init__.py
...
</div>
下面来简单介绍一下各个文件的作用:
scrapy.cfg:项目的配置文件
tutorial/:项目的Python模块,将会从这里引用代码
tutorial/items.py:项目的items文件
tutorial/pipelines.py:项目的pipelines文件
tutorial/settings.py:项目的设置文件
tutorial/spiders/:存储爬虫的目录
2.明确目标(Item)
在Scrapy中,items是用来加载抓取内容的容器,有点像Python中的Dic,也就是字典,但是提供了一些额外的保护减少错误。
一般来说,item可以用scrapy.item.Item类来创建,并且用scrapy.item.Field对象来定义属性(可以理解成类似于ORM的映射关系)。
接下来,我们开始来构建item模型(model)。
首先,我们想要的内容有:
名称(name)
链接(url)
描述(description)
修改tutorial目录下的items.py文件,在原本的class后面添加我们自己的class。
因为要抓dmoz.org网站的内容,所以我们可以将其命名为DmozItem:
# Define here the models for your scraped items
#
# See documentation in:
# http://doc.scrapy.org/en/latest/topics/items.html
from scrapy.item import Item, Field
class TutorialItem(Item):
# define the fields for your item here like:
# name = Field()
pass
class DmozItem(Item):
title = Field()
link = Field()
desc = Field()
</div>
刚开始看起来可能会有些看不懂,但是定义这些item能让你用其他组件的时候知道你的 items到底是什么。
可以把Item简单的理解成封装好的类对象。
3.制作爬虫(Spider)
制作爬虫,总体分两步:先爬再取。
也就是说,首先你要获取整个网页的所有内容,然后再取出其中对你有用的部分。
3.1爬
Spider是用户自己编写的类,用来从一个域(或域组)中抓取信息。
他们定义了用于下载的URL列表、跟踪链接的方案、解析网页内容的方式,以此来提取items。
要建立一个Spider,你必须用scrapy.spider.BaseSpider创建一个子类,并确定三个强制的属性:
name:爬虫的识别名称,必须是唯一的,在不同的爬虫中你必须定义不同的名字。
start_urls:爬取的URL列表。爬虫从这里开始抓取数据,所以,第一次下载的数据将会从这些urls开始。其他子URL将会从这些起始URL中继承性生成。
parse():解析的方法,调用的时候传入从每一个URL传回的Response对象作为唯一参数,负责解析并匹配抓取的数据(解析为item),跟踪更多的URL。
这里可以参考宽度爬虫教程中提及的思想来帮助理解,教程传送:[Java] 知乎下巴第5集:使用HttpClient工具包和宽度爬虫。
也就是把Url存储下来并依此为起点逐步扩散开去,抓取所有符合条件的网页Url存储起来继续爬取。
下面我们来写第一只爬虫,命名为dmoz_spider.py,保存在tutorial\spiders目录下。
dmoz_spider.py代码如下:
from scrapy.spider import Spider
class DmozSpider(Spider):
name = "dmoz"
allowed_domains = ["dmoz.org"]
start_urls = [
"http://www.dmoz.org/Computers/Programming/Languages/Python/Books/",
"http://www.dmoz.org/Computers/Programming/Languages/Python/Resources/"
]
def parse(self, response):
filename = response.url.split("/")[-2]
open(filename, 'wb').write(response.body)
</div>
allow_domains是搜索的域名范围,也就是爬虫的约束区域,规定爬虫只爬取这个域名下的网页。
从parse函数可以看出,将链接的最后两个地址取出作为文件名进行存储。
然后运行一下看看,在tutorial目录下按住shift右击,在此处打开命令窗口,输入:
scrapy crawl dmoz
</div>
运行结果如图:
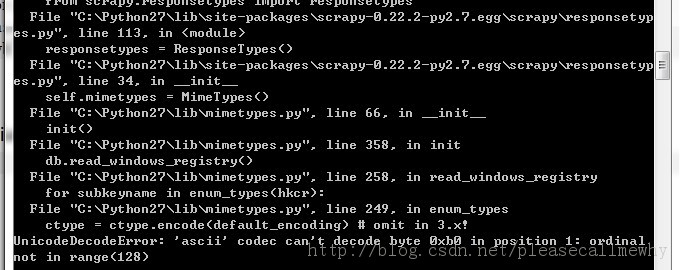
报错了:
UnicodeDecodeError: 'ascii' codec can't decode byte 0xb0 in position 1: ordinal not in range(128)
运行第一个Scrapy项目就报错,真是命运多舛。
应该是出了编码问题,谷歌了一下找到了解决方案:
在python的Lib\site-packages文件夹下新建一个sitecustomize.py:
import sys
sys.setdefaultencoding('gb2312')
</div>
再次运行,OK,问题解决了,看一下结果:
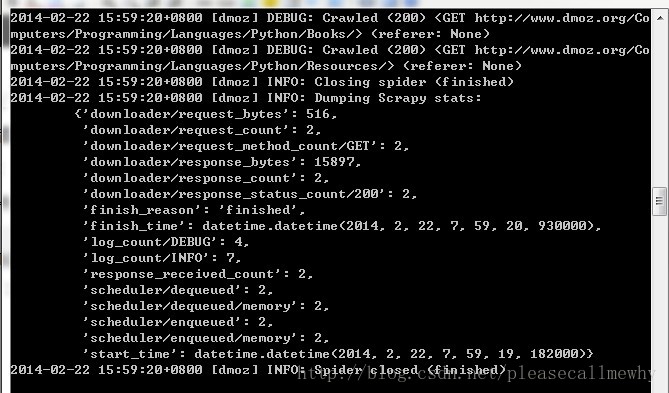
最后一句INFO: Closing spider (finished)表明爬虫已经成功运行并且自行关闭了。
包含 [dmoz]的行 ,那对应着我们的爬虫运行的结果。<