

【Spark】Spark基本概念,spark基本概念
Spark专用名词
- RDD —- resillient distributed dataset 弹性分布式数据集
- Operation —- 作用于RDD的各种操作分为transformation和action
- Job —- 作业,一个JOB包含多个RDD及作用于相应RDD上的各种operation
- Stage —- 一个作业分为多个阶段
- Partition —- 数据分区, 一个RDD中的数据可以分成多个不同的区
- DAG —- Directed Acycle graph, 有向无环图,反应RDD之间的依赖关系
- Narrow dependency —- 窄依赖,子RDD依赖于父RDD中固定的data partition
- Wide Dependency —- 宽依赖,子RDD对父RDD中的所有data partition都有依赖
- Caching Managenment —- 缓存管理,对RDD的中间计算结果进行缓存管理以加快整体的处理速度
Spark编程模型
下面是Spark的一个日志计数示例,该程序演示了Spark的计算模型:

下面是Spark运行时涉及的各组件的概况图:

从RDD转换和存储角度,用户程序对RDD通过多个函数进行操作,将RDD进行转换。Block Manager管理RDD的物理分区,每个Block就是节点上对应的一个数据块,可以存储在内存或磁盘。而RDD中的partition是一个逻辑数据块,对应相应的物理块Block。
本质上,一个RDD在代码中相当于是数据的一个元数据结构,存储着数据分区及其逻辑结构映射关系,存储着RDD之前的依赖转换关系。

作用于RDD上的操作分为transformantion和action。 经Transformation处理之后,数据集中的内容会发生更改,由数据集A转换成为数据集B;而经Action处理之后,数据集中的内容会被归约为一个具体的数值。
只有当RDD上有action时,该RDD及其父RDD上的所有operation才会被提交到cluster中真正的被执行。

Spark运行态
用Spark的术语来说,static view称为dataset-level view,而dynamic view称为parition-level view,关系如图所示:

在Spark中的task可以对应于线程,worker是一个个的进程,worker由driver来进行管理。
在源码阅读时,需要重点把握以下两大主线:
* 静态视图static view 即 RDD, transformation and action
* 动态视图dynamic view 即 life of a job,每一个job又分为多个stage,每一个stage中可以包含多个rdd及其transformation,这些stage又是如何映射成为task被distributed到cluster中
Spark调度机制
Spark应用提交后经历了一系列的转换,最后成为Task在每个节点上执行。
当有Action作用于某RDD时,该action会作为一个job被提交。
在提交的过程中,DAGScheduler模块介入运算,计算RDD之间的依赖关系。RDD之间的依赖关系就形成了DAG。
每一个Job被分为多个stage,划分stage的一个主要依据是当前计算因子的输入是否是确定的,如果是则将其分在同一个stage,避免多个stage之间的消息传递开销。
当stage被提交之后,由taskscheduler来根据stage来计算所需要的task,并将task提交到对应的worker。
大体概况如下图所示:
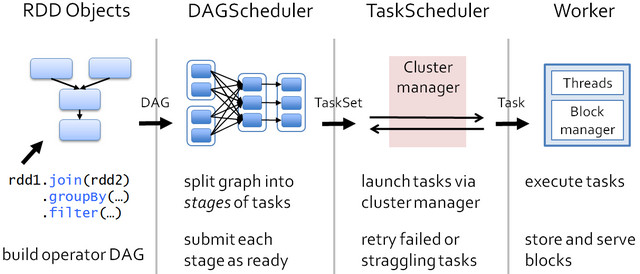
关于Spark的调度运行机制详见下一节的RDD详解中的介绍。
转载请注明作者Jason Ding及其出处
GitCafe博客主页(http://jasonding1354.gitcafe.io/)
Github博客主页(http://jasonding1354.github.io/)
CSDN博客(http://blog.csdn.net/jasonding1354)
简书主页(http://www.jianshu.com/users/2bd9b48f6ea8/latest_articles)
Google搜索jasonding1354进入我的博客主页
版权声明:本文为博主原创文章,未经博主允许不得转载。