

本文实例讲述了Python结巴中文分词工具使用过程中遇到的问题及解决方法。分享给大家供大家参考,具体如下:
结巴分词是Python语言中效果最好的分词工具,其功能包括:分词、词性标注、关键词抽取、支持用户词表等。这几天一直在研究这个工具,在安装与使用过程中遇到一些问题,现在把自己的一些方法帖出来分享一下。
官网地址:https://github.com/fxsjy/jieba
1、安装。
按照官网上的说法,有三种安装方式,
第一种是全自动安装:easy_install jieba 或者 pip install jieba,可是并没有找到它提供这个安装程序。
第二种方法是半自动安装:先下载http://pypi.python.org/pypi/jieba/ ,解压后在cmd命令行中运行 python setup.py install。这里需要注意的是,默认情况下,不能在cmd中直接运行python命令,需要把它的路径加入到环境变量path中方可。我试过,可行。但是 这种方法安装之后,结巴分词功能只能在Python自带的IDLE中使用。在含有PyDEV的MyEclipse中不能执行“import jieba”命令,所以继续尝试第三种方法。
第三种方法是手动安装:将jieba目录放置于当前目录或者site-packages目录。把下载到的jieba-0.30.zip解压后,里面有个jibba的文件夹,把它复制到与你的Python程序相同的位置,这样在程序中就可以执行“import jieba”了。
2、关于分词的实现
官网提供了分词的基本用法示例 :
#encoding=utf-8
import jieba
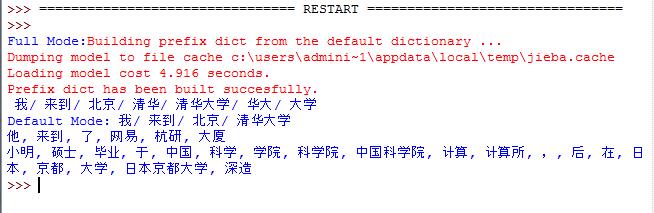
seg_list = jieba.cut("我来到北京清华大学", cut_all=True)
print "Full Mode:", "/ ".join(seg_list) # 全模式
seg_list = jieba.cut("我来到北京清华大学", cut_all=False)
print "Default Mode:", "/ ".join(seg_list) # 精确模式
seg_list = jieba.cut("他来到了网易杭研大厦") # 默认是精确模式
print ", ".join(seg_list)
seg_list = jieba.cut_for_search("小明硕士毕业于中国科学院计算所,后在日本京都大学深造") # 搜索引擎模式
print ", ".join(seg_list)
</div>
程序可以执行,但是在MyEclipse中显示中文为Unicode编码,这不科学。
但是继续执行另一个词性标注的示例却非常正常:
import jieba.posseg as pseg
words = pseg.cut("我爱北京天安门")
for w in words:
  print w.word, w.flag
</div>
所以我就想去分析一下它的源代码,结果发现在jiba/_init_.py文件(这是实现分词的文件)的第209行(cut函数)中有关于检查编码的语句块:
if not isinstance(sentence, unicode):
  try:
   sentence = sentence.decode('utf-8')
  except UnicodeDecodeError:
   sentence = sentence.decode('gbk','ignore')
</div>
而在jieba/posseg/_init_.py文件(这是实现词性标注的文件)第158行的cut函数中却没有发现此类代码。所以我猜想,前者有检查编码的代码就出现乱码,而后者没有检查编码的代码而正常显示,所以就把前者检查编码的代码给注释了,结果程序执行报错,只好又把人家的源码还原,结果中文又正常显示了!
运行效果如下图:
以上只是对固定的中文字符串变量进行分词和词性标注,接下来的文章里我会尝试从文件中读取中文进行分词和词性标注。
更多关于Python相关内容可查看本站专题:《Python字典操作技巧汇总》、《Python字符串操作技巧汇总》、《Python常用遍历技巧总结》、《Python数据结构与算法教程》、《Python函数使用技巧总结》及《Python入门与进阶经典教程》
希望本文所述对大家Python程序设计有所帮助。
</div>