

前面我通过一篇文章讲述了如何爬取CSDN的博客摘要等信息。通常,在使用Selenium爬虫爬取数据后,需要存储在TXT文本中,但是这是很难进行数据处理和数据分析的。这篇文章主要讲述通过Selenium爬取我的个人博客信息,然后存储在数据库MySQL中,以便对数据进行分析,比如分析哪个时间段发表的博客多、结合WordCloud分析文章的主题、文章阅读量排名等。
这是一篇基础性的文章,希望对您有所帮助,如果文章中出现错误或不足之处,还请海涵。下一篇文章会简单讲解数据分析的过程。
一. 爬取的结果
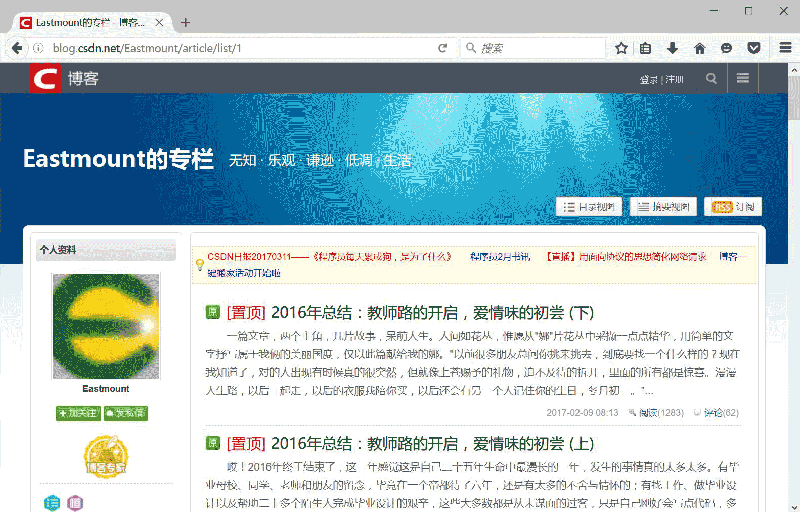
爬取的地址为:http://blog.csdn.net/Eastmount
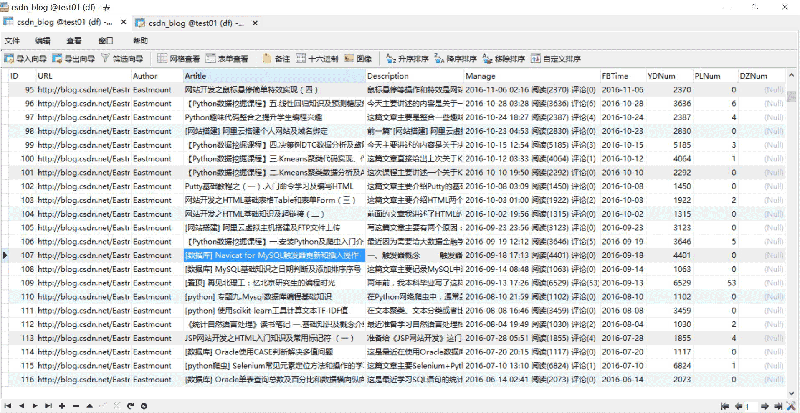
爬取并存储至MySQL数据库的结果如下所示:
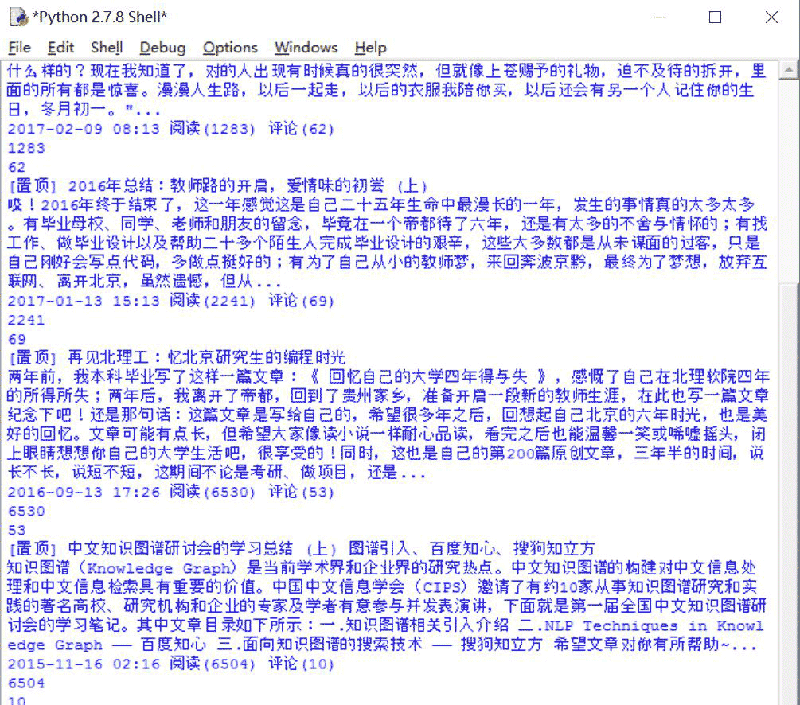
运行过程如下图所示:
二. 完整代码分析
完整代码如下所示:
# coding=utf-8

from selenium import webdriver
from selenium.webdriver.common.keys import Keys
import selenium.webdriver.support.ui as ui
import re
import time
import os
import codecs
import MySQLdb

#打开Firefox浏览器 设定等待加载时间
driver = webdriver.Firefox()
wait = ui.WebDriverWait(driver,10)

#获取每个博主的博客页面低端总页码
def getPage():
 print 'getPage'
 number = 0
 texts = driver.find_element_by_xpath("//div[@id='papelist']").text
 print '页码', texts
 m = re.findall(r'(\w*[0-9]+)\w*',texts) #正则表达式寻找数字
 print '页数:' + str(m[1])
 return int(m[1])

#主函数
def main():
 #获取txt文件总行数
 count = len(open("Blog_URL.txt",'rU').readlines())
 print count
 n = 0
 urlfile = open("Blog_URL.txt",'r')

 #循环获取每个博主的文章摘信息
 while n < count: #这里爬取2个人博客信息,正常情况count个博主信息
  url = urlfile.readline()
  url = url.strip("\n")
  print url
  driver.get(url)
  #获取总页码
  allPage = getPage()
  print u'页码总数为:', allPage
  time.sleep(2)

  #数据库操作结合
  try:
   conn=MySQLdb.connect(host='localhost',user='root',
         passwd='123456',port=3306, db='test01')
   cur=conn.cursor() #数据库游标

   #报错:UnicodeEncodeError: 'latin-1' codec can't encode character
   conn.set_character_set('utf8')
   cur.execute('SET NAMES utf8;')
   cur.execute('SET CHARACTER SET utf8;')
   cur.execute('SET character_set_connection=utf8;')

   #具体内容处理
   m = 1 #第1页
   while m <= allPage:
    ur = url + "/article/list/" + str(m)
    print ur
    driver.get(ur)

    #标题
    article_title = driver.find_elements_by_xpath("//div[@class='article_title']")
    for title in article_title:
     #print url
     con = title.text
     con = con.strip("\n")
     #print con + '\n'

    #摘要
    article_description = driver.find_elements_by_xpath("//div[@class='article_description']")
    for description in article_description:
     con = description.text
     con = con.strip("\n")
     #print con + '\n'

    #信息
    article_manage = driver.find_elements_by_xpath("//div[@class='article_manage']")
    for manage in article_manage:
     con = manage.text
     con = con.strip("\n")
     #print con + '\n'

    num = 0
    print u'长度', len(article_title)
    while num < len(article_title):
     #插入数据 8个值
     sql = '''insert into csdn_blog
        (URL,Author,Artitle,Description,Manage,FBTime,YDNum,PLNum)
       values(%s, %s, %s, %s, %s, %s, %s, %s)'''
     Artitle = article_title[num].text
     Description = article_description[num].text
     Manage = article_manage[num].text
     print Artitle
     print Description
     print Manage
     #获取作者
     Author = url.split('/')[-1]
     #获取阅读数和评论数
     mode = re.compile(r'\d+\.?\d*')
     YDNum = mode.findall(Manage)[-2]
     PLNum = mode.findall(Manage)[-1]
     print YDNum
     print PLNum
     #获取发布时间
     end = Manage.find(u' 阅读')
     FBTime = Manage[:end]
     cur.execute(sql, (url, Author, Artitle, Description, Manage,FBTime,YDNum,PLNum))

     num = num + 1
    else:
     print u'数据库插入成功'
    m = m + 1


  #异常处理
  except MySQLdb.Error,e:
   print "Mysql Error %d: %s" % (e.args[0], e.args[1])
  finally:
   cur.close()
   conn.commit()
   conn.close()

  n = n + 1

 else:
  urlfile.close()
  print 'Load Over'

main()
</div>
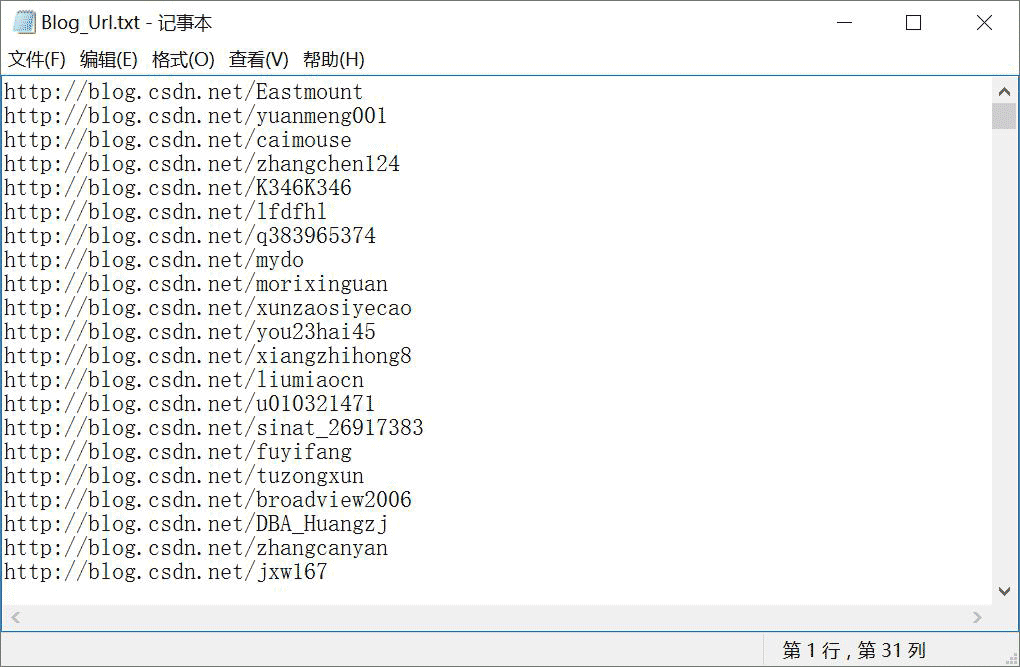
在Blog_Url.txt文件中放置需要爬取用户的博客地址URL,如下图所示。注意在此处,作者预先写了个爬取CSDN所有专家的URL代码,这里为访问其他人用于提升阅读量已省略。
分析过程如下所示。
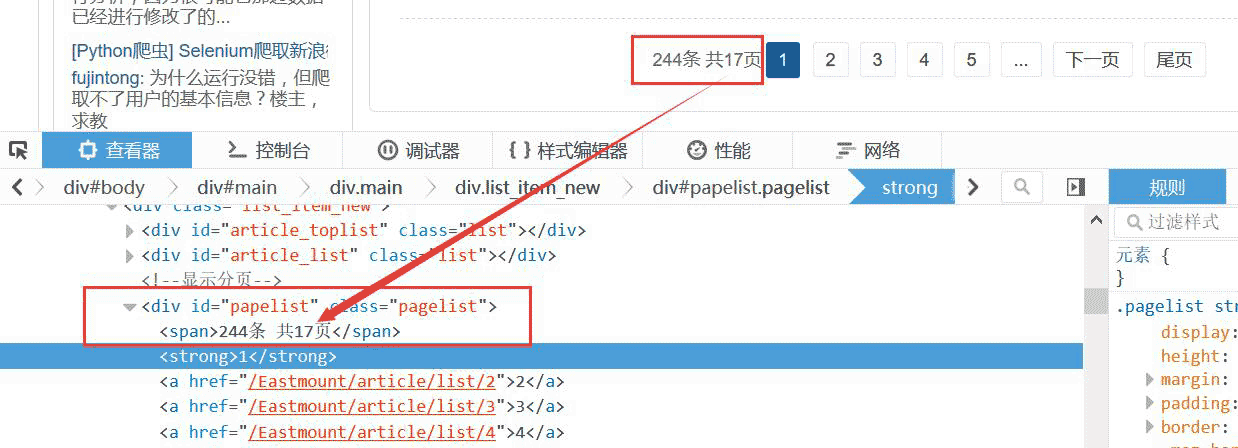
1.获取博主总页码
首先从Blog_Url.txt读取博主地址,然后访问并获取页码总数。代码如下:
#获取每个博主的博客页面低端总页码
def getPage():
 print 'getPage'
 number = 0
 texts = driver.find_element_by_xpath("//div[@id='papelist']").text
 print '页码', texts
 m = re.findall(r'(\w*[0-9]+)\w*',texts) #正则表达式寻找数字
 print '页数:' + str(m[1])
 return int(m[1])
</div>
比如获取总页码位17页,如下图所示:
2.翻页DOM树分析
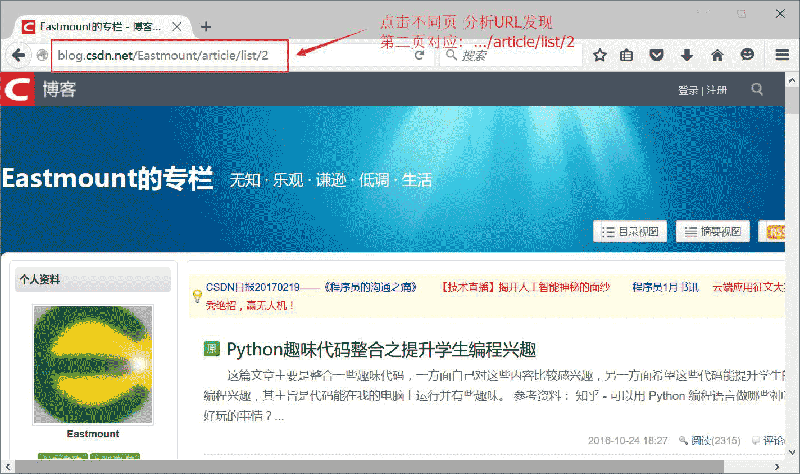
这里的博客翻页采用的是URL连接,比较方便。
如:http://blog.csdn.net/Eastmount/article/list/2
故只需要 :1.获取总页码;2.爬取每页信息;3.URL设置进行循环翻页;4.再爬取。
也可以采用点击"下页"跳转,没有"下页"停止跳转,爬虫结束,接着爬取下一个博主。
3.获取详细信息:标题、摘要、时间
然后审查元素分析每个博客页面,如果采用BeautifulSoup爬取会报错"Forbidden"。
发现每篇文章都是由一个<div></div>组成,如下所示,只需要定位到该位置即可。
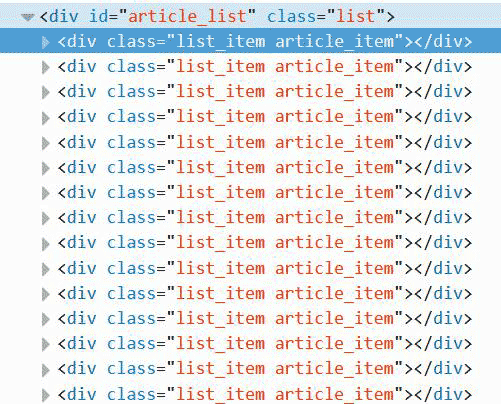
这里定位到该位置即可爬取,这里需要分别定位标题、摘要、时间。
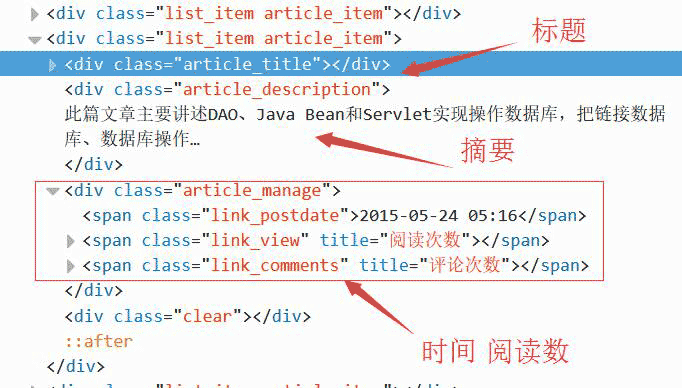
代码如下所示。注意,在while中同时获取三个值,它们是对应的。
#标题
article_title = driver.find_elements_by_xpath("//div[@class='article_title']")
for title in article_title:
 con = title.text
 con = con.strip("\n")
 print con + '\n'

#摘要
article_description = driver.find_elements_by_xpath("//div[@class='article_description']")
for description in article_description:
 con = description.text
 con = con.strip("\n")
 print con + '\n'

#信息
article_manage = driver.find_elements_by_xpath("//div[@class='article_manage']")
for manage in article_manage:
 con = manage.text
 con = con.strip("\n")
 print con + '\n'

num = 0
print u'长度', len(article_title)
while num < len(article_title):
 Artitle = article_title[num].text
 Description = article_description[num].text
 Manage = article_manage[num].text
 print Artitle, Description, Manage
</div>
4.特殊字符串处理
获取URL最后一个/后的博主名称、获取字符串时间、阅读数代码如下:
#获取博主姓名
url = "http://blog.csdn.net/Eastmount"
print url.split('/')[-1]
#输出: Eastmount
#获取数字
name = "2015-09-08 18:06 阅读(909) 评论(0)"
print name
import re
mode = re.compile(r'\d+\.?\d*')
print mode.findall(name)
#输出: ['2015', '09', '08', '18', '06', '909', '0']
print mode.findall(name)[-2]
#输出: 909
#获取时