

Scrapy
Scrapy是一个比较好用的Python爬虫框架,你只需要编写几个组件就可以实现网页数据的爬取。但是当我们要爬取的页面非常多的时候,单个主机的处理能力就不能满足我们的需求了(无论是处理速度还是网络请求的并发数),这时候分布式爬虫的优势就显现出来。
而Scrapy-Redis则是一个基于Redis的Scrapy分布式组件。它利用Redis对用于爬取的请求(Requests)进行存储和调度(Schedule),并对爬取产生的项目(items)存储以供后续处理使用。scrapy-redi重写了scrapy一些比较关键的代码,将scrapy变成一个可以在多个主机上同时运行的分布式爬虫。
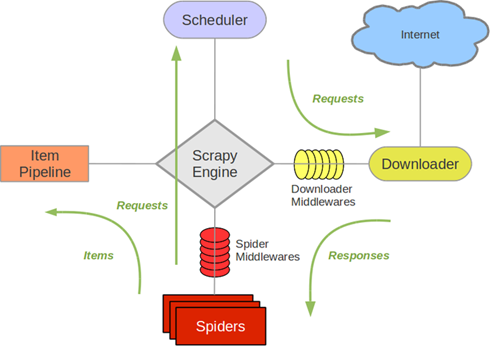
原生的Scrapy的架构是这样子的:
加上了Scrapy-Redis之后的架构变成了:
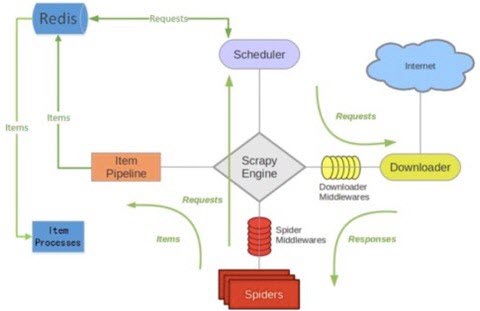
scrapy-redis的官方文档写的比较简洁,没有提及其运行原理,所以如果想全面的理解分布式爬虫的运行原理,还是得看scrapy-redis的源代码才行,不过scrapy-redis的源代码很少,也比较好懂,很快就能看完。
scrapy-redis工程的主体还是是redis和scrapy两个库,工程本身实现的东西不是很多,这个工程就像胶水一样,把这两个插件粘结了起来。
scrapy-redis提供了哪些组件?
scrapy-redis所实现的两种分布式:爬虫分布式以及item处理分布式。分别是由模块scheduler和模块pipelines实现。
connection.py
负责根据setting中配置实例化redis连接。被dupefilter和scheduler调用,总之涉及到redis存取的都要使用到这个模块。
import redis
import six
from scrapy.utils.misc import load_object
DEFAULT_REDIS_CLS = redis.StrictRedis
# Sane connection defaults.
DEFAULT_PARAMS = {
 'socket_timeout': 30,
 'socket_connect_timeout': 30,
 'retry_on_timeout': True,
}
# Shortcut maps 'setting name' -> 'parmater name'.
SETTINGS_PARAMS_MAP = {
 'REDIS_URL': 'url',
 'REDIS_HOST': 'host',
 'REDIS_PORT': 'port',
}
def get_redis_from_settings(settings):
 """Returns a redis client instance from given Scrapy settings object.
 This function uses ``get_client`` to instantiate the client and uses
 ``DEFAULT_PARAMS`` global as defaults values for the parameters. You can
 override them using the ``REDIS_PARAMS`` setting.
 Parameters
 ----------
 settings : Settings
  A scrapy settings object. See the supported settings below.
 Returns
 -------
 server
  Redis client instance.
 Other Parameters
 ----------------
 REDIS_URL : str, optional
  Server connection URL.
 REDIS_HOST : str, optional
  Server host.
 REDIS_PORT : str, optional
  Server port.
 REDIS_PARAMS : dict, optional
  Additional client parameters.
 """
 params = DEFAULT_PARAMS.copy()
 params.update(settings.getdict('REDIS_PARAMS'))
 # XXX: Deprecate REDIS_* settings.
 for source, dest in SETTINGS_PARAMS_MAP.items():
  val = settings.get(source)
  if val:
   params[dest] = val
 # Allow ``redis_cls`` to be a path to a class.
 if isinstance(params.get('redis_cls'), six.string_types):
  params['redis_cls'] = load_object(params['redis_cls'])
 return get_redis(**params)
# Backwards compatible alias.
from_settings = get_redis_from_settings
def get_redis(**kwargs):
 """Returns a redis client instance.
 Parameters
 ----------
 redis_cls : class, optional
  Defaults to ``redis.StrictRedis``.
 url : str, optional
  If given, ``redis_cls.from_url`` is used to instantiate the class.
 **kwargs
  Extra parameters to be passed to the ``redis_cls`` class.
 Returns
 -------
 server
  Redis client instance.
 """
 redis_cls = kwargs.pop('redis_cls', DEFAULT_REDIS_CLS)
 url = kwargs.pop('url', None)
 if url:
  return redis_cls.from_url(url, **kwargs)
 else:
  return redis_cls(**kwargs)
</div>
connect文件引入了redis模块,这个是redis-python库的接口,用于通过python访问redis数据库,可见,这个文件主要是实现连接redis数据库的功能(返回的是redis库的Redis对象或者StrictRedis对象,这俩都是可以直接用来进行数据操作的对象)。这些连接接口在其他文件中经常被用到。其中,我们可以看到,要想连接到redis数据库,和其他数据库差不多,需要一个ip地址、端口号、用户名密码(可选)和一个整形的数据库编号,同时我们还可以在scrapy工程的setting文件中配置套接字的超时时间、等待时间等。
dupefilter.py
负责执行requst的去重,实现的很有技巧性,使用redis的set数据结构。但是注意scheduler并不使用其中用于在这个模块中实现的dupefilter键做request的调度,而是使用queue.py模块中实现的queue。当request不重复时,将其存入到queue中,调度时将其弹出。
import logging
import time
from scrapy.dupefilters import BaseDupeFilter
from scrapy.utils.request import request_fingerprint
from .connection import get_redis_from_settings
DEFAULT_DUPEFILTER_KEY = "dupefilter:%(timestamp)s"
logger = logging.getLogger(__name__)
# TODO: Rename class to RedisDupeFilter.
class RFPDupeFilter(BaseDupeFilter):
"""Redis-based request duplicates filter.
This class can also be used with default Scrapy's scheduler.
"""
logger = logger
def __init__(self, server, key, debug=False):
"""Initialize the duplicates filter.
Parameters
----------
server : redis.StrictRedis
The redis server instance.
key : str
Redis key Where to store fingerprints.
debug : bool, optional
Whether to log filtered requests.
"""
self.server = server
self.key = key
self.debug = debug
self.logdupes = True
@classmethod
def from_settings(cls, settings):
"""Returns an instance from given settings.
This uses by default the key ``dupefilter:<timestamp>``. When using the
``scrapy_redis.scheduler.Scheduler`` class, this method is not used as
it needs to pass the spider name in the key.
Parameters
----------
settings : scrapy.settings.Settings
Returns
-------
RFPDupeFilter
A RFPDupeFilter instance.
"""
server = get_redis_from_settings(settings)
# XXX: This creates one-time key. needed to support to use this
# class as standalone dupefilter with scrapy's default scheduler
# if scrapy passes spider on open() method this wouldn't be needed
# TODO: Use SCRAPY_JOB env as default and fallback to timestamp.
key = DEFAULT_DUPEFILTER_KEY % {'timestamp': int(time.time())}
debug = settings.getbool('DUPEFILTER_DEBUG')
return cls(server, key=key, debug=debug)
@classmethod
def from_crawler(cls, crawler):
"""Returns instance from crawler.
Parameters
----------
crawler : scrapy.crawler.Crawler
Returns
-------
RFPDupeFilter
Instance of RFPDupeFilter.
"""
return cls.from_settings(crawler.settings)
def request_seen(self, request):
"""Returns True if request was already seen.
Parameters
----------
request : scrapy.http.Request
Returns
-------
bool
"""
fp = self.request_fingerprint(request)
# This returns the number of values added, zero if already exists.
added = self.server.sadd(self.key, fp)
return added == 0
def request_fingerprint(self, request):
"""Returns a fingerprint for a given request.
Parameters
----------
request : scrapy.http.Request
Returns
-------
str
"""
return request_fingerprint(request)
def close(self, reason=''):
"""Delete data on close. Called by Scrapy's scheduler.
Parameters
----------
reason : str, optional
"""
self.clear()
def clear(self):
"""Clears fingerprints data."""
self.server.delete(self.key)
def log(self, request, spider):
"""Logs given request.
Parameters
----------
request : scrapy.http.Request
spider : scrapy.spiders.Spider
"""
if self.debug:
msg = "Filtered duplicate request: %(request)s"
self.logger.debug(msg, {'request': request}, extra={'spider': spider})
elif self.lo