

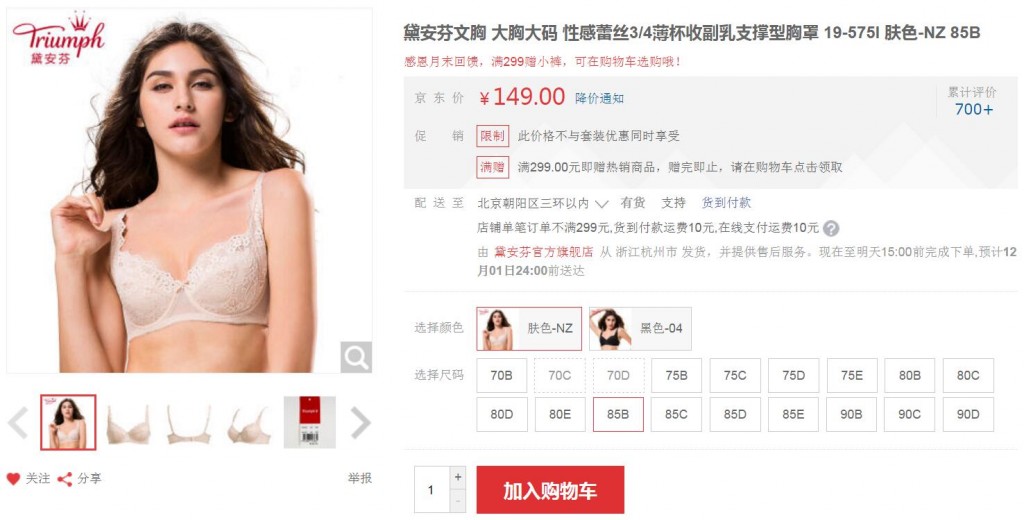
本篇文章是python爬虫系列的第三篇,介绍如何抓取京东商城商品评论信息,并对这些评论信息进行分析和可视化。下面是要抓取的商品信息,一款女士文胸。这个商品共有红色,黑色和肤色三种颜色, 70B到90D共18个尺寸,以及超过700条的购买评论。
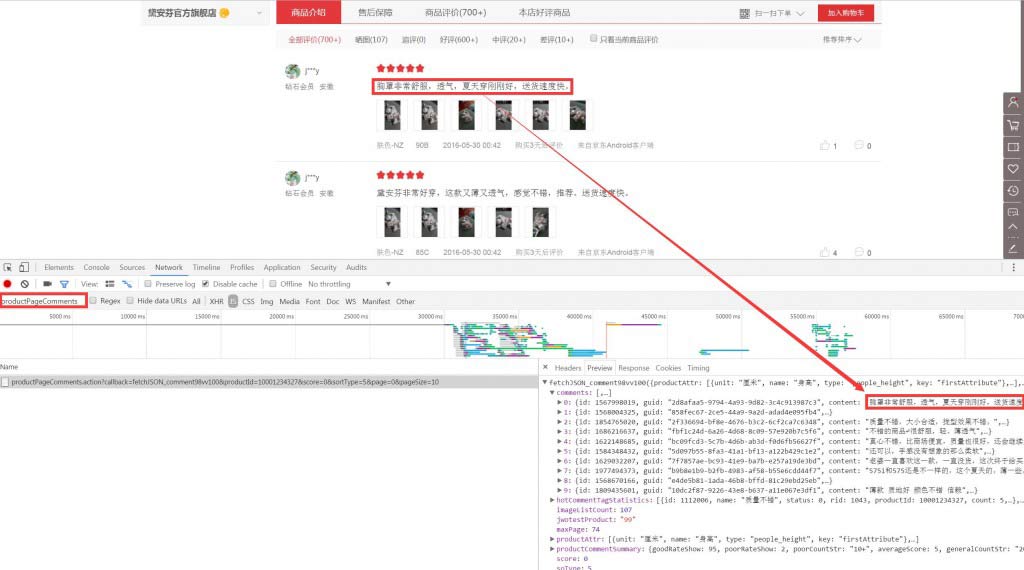
京东商品评论信息是由JS动态加载的,所以直接抓取商品详情页的URL并不能获得商品评论的信息。因此我们需要先找到存放商品评论信息的文件。这里我们使用Chrome浏览器里的开发者工具进行查找。
具体方法是在商品详情页点击鼠标右键,选择检查,在弹出的开发者工具界面中选择Network,设置为禁用缓存(Disable cache)和只查看JS文件。然后刷新页面。页面加载完成后向下滚动鼠标找到商品评价部分,等商品评价信息显示出来后,在下面Network界面的左侧筛选框中输入productPageComments,这时下面的加载记录中只有一条信息,这里包含的就是商品详情页的商品评论信息。点击这条信息,在右侧的Preview界面中可以看到其中包含了当前页面中的评论信息。(抓取价格信息输入prices)。
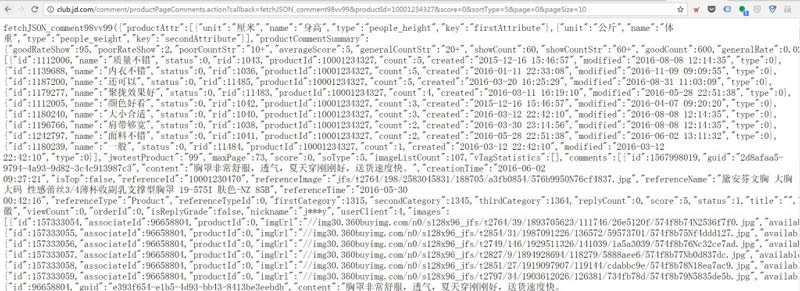
复制这条信息,并把URL地址放在浏览器中打开,里面包含了当前页的商品评论信息。这就是我们要抓取的URL地址。https://club.jd.com/comment/productPageComments.action?callback=fetchJSON_comment98vv100&productId=10001234327&score=0&sortType=5&page=0&pageSize=10
仔细观察这条URL地址可以发现,其中productId=10001234327是当前商品的商品ID。与商品详情页URL中的ID一致。而page=0是页码。如果我们要获取这个商品的所有评论,只需要更改page后面的数字即可。
在获得了商品评论的真实地址以及URL地址的规律后,我们开始使用python抓取这件商品的700+条评论信息。并对这些信息进行处理和分析。
开始前的准备工作
在开始抓取之前先要导入各种库文件,这里我们分别介绍下需要导入的每个库文件的名称以及在数据抓取和分析中的作用。requests用于进行页面抓取,time用于设置抓取过程中的Sleep时间,random用于生产随机数,这里的作用是将抓取页面的顺序打乱,re用于在抓取后的页面代码中提取需要的信息,numpy用于常规的指标计算,pandas用于进行数据汇总和透视分析,matplotlib用于绘制各站图表,jieba用于对评论内容进行分词和关键词提取。
#导入requests库(请求和页面抓取)
import requests
#导入time库(设置抓取Sleep时间)
import time
#导入random库(生成乱序随机数)
import random
#导入正则库(从页面代码中提取信息)
import re
#导入数值计算库(常规计算)
import numpy as np
#导入科学计算库(拼表及各种分析汇总)
import pandas as pd
#导入绘制图表库(数据可视化)
import matplotlib.pyplot as plt
#导入结巴分词库(分词)
import jieba as jb
#导入结巴分词(关键词提取)
import jieba.analyse
</div>
将爬虫伪装成浏览器
导入完库文件后,还不能直接进行抓取,因为这样很容易被封。我们还需要对爬虫进行伪装,是爬虫看起来更像是来自浏览器的访问。这里主要的两个工作是设置请求中的头文件信息以及设置Cookie的内容。
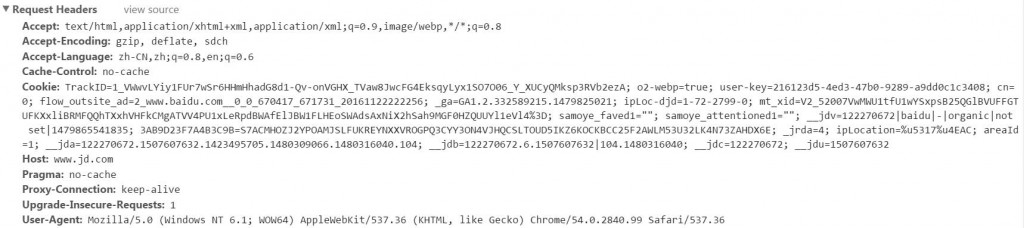
头文件信息很容易找到,在Chrome的开发者工具中选择Network,刷新页面后选择Headers就可以看到本次访问的头文件信息,里面包含了一些浏览器的技术参数和引荐来源信息。将这些信息直接添加到代码中就可以,这里我们将头部信息保存在headers中。
#设置请求中头文件的信息
headers = {'User-Agent':'Mozilla/5.0 (Windows NT 6.1) AppleWebKit/537.11 (KHTML, like Gecko) Chrome/23.0.1271.64 Safari/537.11',
'Accept':'text/html;q=0.9,*/*;q=0.8',
'Accept-Charset':'ISO-8859-1,utf-8;q=0.7,*;q=0.3',
'Connection':'close',
'Referer':'https://www.jd.com/'
}
</div>
在查看头文件信息的旁边还有一个Cookies标签,点击进去就是本次访问的Cookies信息。这里的Cookies信息与前面头文件中的Cookie信息一致,不过这里更加清晰。把Request Cookies信息复制到代码中即可,这里我们将Request Cookies信息保存在Cookie中。
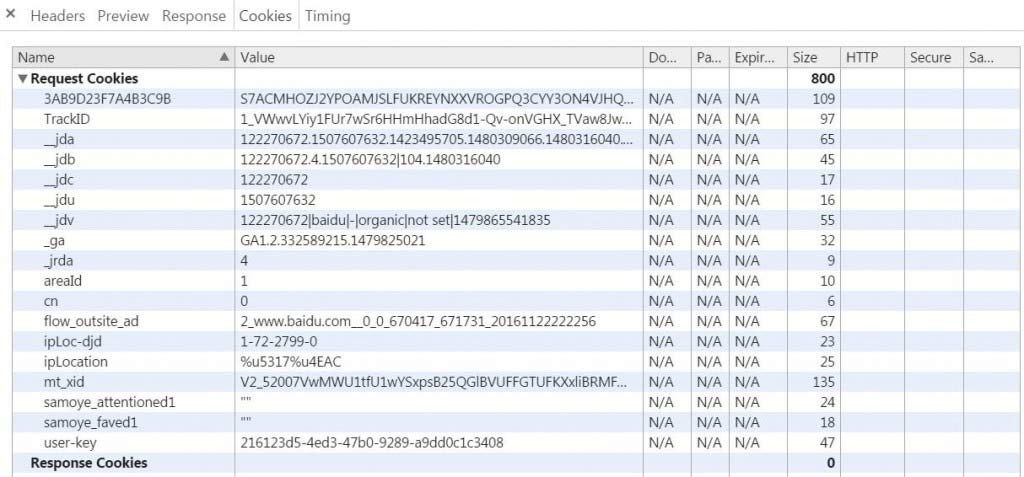
#设置Cookie的内容
cookie={'TrackID':'1_VWwvLYiy1FUr7wSr6HHmHhadG8d1-Qv-TVaw8JwcFG4EksqyLyx1SO7O06_Y_XUCyQMksp3RVb2ezA',
'__jda':'122270672.1507607632.1423495705.1479785414.1479794553.92',
'__jdb':'122270672.1.1507607632|92.1479794553',
'__jdc':'122270672',
'__jdu':'1507607632',
'__jdv':'122270672|direct|-|none|-|1478747025001',
'areaId':'1',
'cn':'0',
'ipLoc-djd':'1-72-2799-0',
'ipLocation':'%u5317%u4EAC',
'mx':'0_X',
'rkv':'V0800',
'user-key':'216123d5-4ed3-47b0-9289-12345',
'xtest':'4657.553.d9798cdf31c02d86b8b81cc119d94836.b7a782741f667201b54880c925faec4b'}
</div>
抓取商品评论信息
设置完请求的头文件和Cookie信息后,我们开始抓取京东商品评论的信息。前面分析URL的时候说过,URL中包含两个重要的信息,一个是商品ID,另一个是页码。这里我们只抓取一个商品的评论信息,因此商品ID不需要更改。但这个商品的评论有700+条,也就是有近80页需要抓取,因此页码不是一个固定值,需要在0-80之间变化。这里我们将URL分成两部分,通过随机生成页码然后拼接URL的方式进行抓取。
#设置URL的第一部分
url1='https://sclub.jd.com/comment/productPageComments.action?productId=10001234327&score=0&sortType=3&page='
#设置URL的第二部分
url2='&pageSize=10&callback=fetchJSON_comment98vv41127'
#乱序输出0-80的唯一随机数
ran_num=random.sample(range(80), 80)
</div>
为了使抓取过程看起来更加随机,我们没有从第1页一直抓取到第80页。而是使用random生成0-80的唯一随机数,也就是要抓取的页码编号。然后再将页码编号与两部分URL进行拼接。这里我们只知道商品有700+的评论,但并不知道具体数字,所以抓取范围定位从0-80页。
下面是具体的抓取过程,使用for循环每次从0-80的随机数中找一个生成页码编号,与两部分的URL进行拼接。生成要抓取的URL地址并与前面设置好的头文件信息和Cookie信息一起发送请求获取页面信息。将获取到的页面信息进行汇总。每次请求间休息5秒针,避免过于频繁的请求导致返回空值。
#拼接URL并乱序循环抓取页面
for i in ran_num:
  a = ran_num[0]
  if i == a:
   i=str(i)
   url=(url1+i+url2)
   r=requests.get(url=url,headers=headers,cookies=cookie)
   html=r.content
  else:
   i=str(i)
   url=(url1+i+url2)
   r=requests.get(url=url,headers=headers,cookies=cookie)
   html2=r.content
   html = html + html2
  time.sleep(5)
  print("当前抓取页面:",url,"状态:",r)
</div>
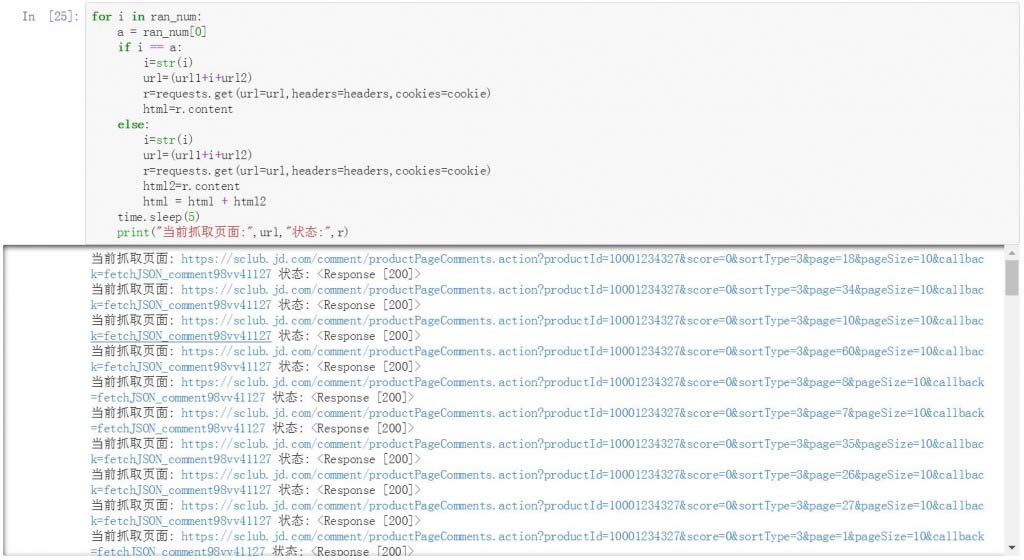
在抓取的过程中输入每一步抓取的页面URL以及状态。通过下面的截图可以看到,在page参数后面的页码是随机生成的并不连续。
抓取完80个页面后,我们还需要对页面进行编码。完成编码后就可以看到其中所包含的中文评论信息了。后面大部分苦逼的工作就是要对这些评论信息进行不断提取和反复的清洗。
#对抓取的页面进行编码
html=str(html, encoding = "GBK")
</div>
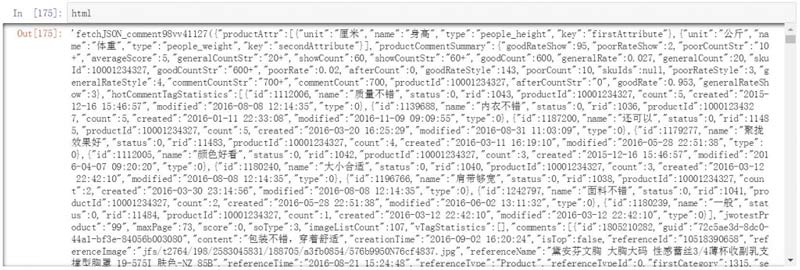
这里建议将抓取完的数据存储在本地,后续工作可以直接从本地打开文件进行清洗和分析工作。避免每次都要重新抓取数据。这里我们将数据保存在桌面的page.txt文件中。
#将编码后的页面输出为txt文本存储
file = open("c:\\Users \\Desktop\\page.txt", "w")
file.write(html)
file.close()
</div>
读取文件也比较简单,直接open加read函数就可以完成了。
#读取存储的txt文本文件
html = open('c:\\Users\\ Desktop\\page.txt', 'r').read()
</div>
提取信息并进行数据清洗
京东的商品评论中包含了很多有用的信息,我们需要将这些信息从页面代码中提取出来,整理成数据表以便进行后续的分析工作。这里应该就是整个过程中最苦逼的数据提取和清洗工作了。我们使用正则对每个字段进行提取。对于特殊的字段在通过替换等方式进行提取和清洗。
下面是提取的第一个字段userClient,也就是用户发布评论时所使用的设备类型,这类的字段提取还比较简单,一行代码搞定。查看一下提取出来的字段还比较干净。使用同样的方法我们分别提取了以下这些字段的内容。
#使用正则提取userClient字段信息 userClie