

写在前面
这次的爬虫是关于房价信息的抓取,目的在于练习10万以上的数据处理及整站式抓取。
数据量的提升最直观的感觉便是对函数逻辑要求的提高,针对Python的特性,谨慎的选择数据结构。以往小数据量的抓取,即使函数逻辑部分重复,I/O请求频率密集,循环套嵌过深,也不过是1~2s的差别,而随着数据规模的提高,这1~2s的差别就有可能扩展成为1~2h。
因此对于要抓取数据量较多的网站,可以从两方面着手降低抓取信息的时间成本。
1)优化函数逻辑,选择适当的数据结构,符合Pythonic的编程习惯。例如,字符串的合并,使用join()要比“+”节省内存空间。
2)依据I/O密集与CPU密集,选择多线程、多进程并行的执行方式,提高执行效率。
一、获取索引
包装请求request,设置超时timeout
# 获取列表页面
def get_page(url):
 headers = {
  'User-Agent': r'Mozilla/5.0 (Windows NT 6.1; WOW64) AppleWebKit/537.36 (KHTML, like Gecko) '
      r'Chrome/45.0.2454.85 Safari/537.36 115Browser/6.0.3',
  'Referer': r'http://bj.fangjia.com/ershoufang/',
  'Host': r'bj.fangjia.com',
  'Connection': 'keep-alive'
 }
 timeout = 60
 socket.setdefaulttimeout(timeout) # 设置超时
 req = request.Request(url, headers=headers)
 response = request.urlopen(req).read()
 page = response.decode('utf-8')
 return page
</div>
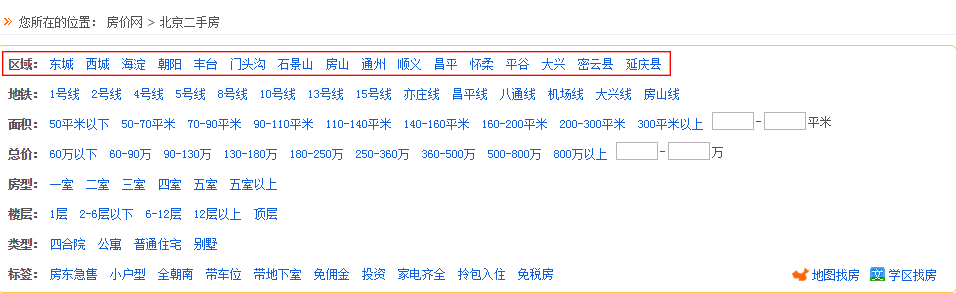
一级位置:区域信息
二级位置:板块信息(根据区域位置得到板块信息,以key_value对的形式存储在dict中)
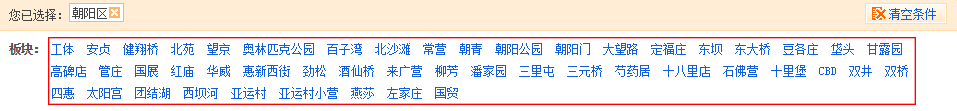
以dict方式存储,可以快速的查询到所要查找的目标。-> {'朝阳':{'工体','安贞','健翔桥'......}}
三级位置:地铁信息(搜索地铁周边房源信息)

将所属位置地铁信息,添加至dict中。 -> {'朝阳':{'工体':{'5号线','10号线' , '13号线'},'安贞','健翔桥'......}}
对应的url:http://bj.fangjia.com/ershoufang/--r-%E6%9C%9D%E9%98%B3%7Cw-5%E5%8F%B7%E7%BA%BF%7Cb-%E6%83%A0%E6%96%B0%E8%A5%BF%E8%A1%97
解码后的url:http://bj.fangjia.com/ershoufang/--r-朝阳|w-5号线|b-惠新西街
根据url的参数模式,可以有两种方式获取目的url:
1)根据索引路径获得目的url

# 获取房源信息列表(嵌套字典遍历)
def get_info_list(search_dict, layer, tmp_list, search_list):
 layer += 1 # 设置字典层级
 for i in range(len(search_dict)):
  tmp_key = list(search_dict.keys())[i] # 提取当前字典层级key
  tmp_list.append(tmp_key) # 将当前key值作为索引添加至tmp_list
  tmp_value = search_dict[tmp_key]
  if isinstance(tmp_value, str): # 当键值为url时
   tmp_list.append(tmp_value) # 将url添加至tmp_list
   search_list.append(copy.deepcopy(tmp_list)) # 将tmp_list索引url添加至search_list
   tmp_list = tmp_list[:layer] # 根据层级保留索引
  elif tmp_value == '': # 键值为空时跳过
   layer -= 2   # 跳出键值层级
   tmp_list = tmp_list[:layer] # 根据层级保留索引
  else:
   get_info_list(tmp_value, layer, tmp_list, search_list) # 当键值为列表时,迭代遍历
   tmp_list = tmp_list[:layer]
 return search_list
</div>
2)根据dict信息包装url
{'朝阳':{'工体':{'5号线'}}}
参数:
—— r-朝阳
—— b-工体
—— w-5号线
组装参数:http://bj.fangjia.com/ershoufang/--r-朝阳|w-5号线|b-工体
1 # 根据参数创建组合url
2 def get_compose_url(compose_tmp_url, tag_args, key_args):
3  compose_tmp_url_list = [compose_tmp_url, '|' if tag_args != 'r-' else '', tag_args, parse.quote(key_args), ]
4  compose_url = ''.join(compose_tmp_url_list)
5  return compose_url
</div>
二、获取索引页最大页数
# 获取当前索引页面页数的url列表
def get_info_pn_list(search_list):
 fin_search_list = []
 for i in range(len(search_list)):
  print('>>>正在抓取%s' % search_list[i][:3])
  search_url = search_list[i][3]
  try:
   page = get_page(search_url)
  except:
   print('获取页面超时')
   continue
  soup = BS(page, 'lxml')
  # 获取最大页数
  pn_num = soup.select('span[class="mr5"]')[0].get_text()
  rule = re.compile(r'\d+')
  max_pn = int(rule.findall(pn_num)[1])
  # 组装url
  for pn in range(1, max_pn+1):
   print('************************正在抓取%s页************************' % pn)
   pn_rule = re.compile('[|]')
   fin_url = pn_rule.sub(r'|e-%s|' % pn, search_url, 1)
   tmp_url_list = copy.deepcopy(search_list[i][:3])
   tmp_url_list.append(fin_url)
   fin_search_list.append(tmp_url_list)
 return fin_search_list
</div>
三、抓取房源信息Tag
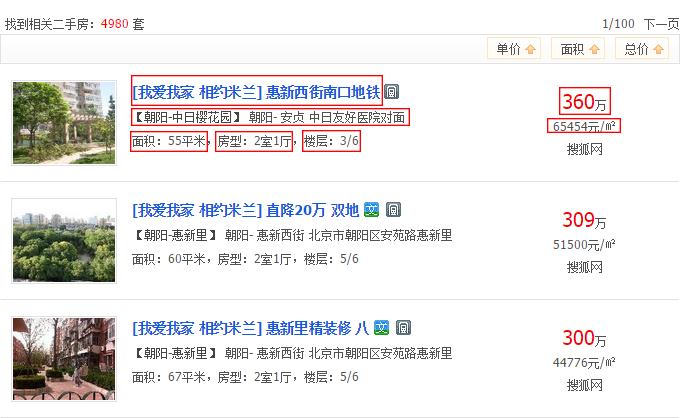
这是我们要抓取的Tag:
['区域', '板块', '地铁', '标题', '位置', '平米', '户型', '楼层', '总价', '单位平米价格']
# 获取tag信息
def get_info(fin_search_list, process_i):
 print('进程%s开始' % process_i)
 fin_info_list = []
 for i in range(len(fin_search_list)):
  url = fin_search_list[i][3]
  try:
   page = get_page(url)
  except:
   print('获取tag超时')
   continue
  soup = BS(page, 'lxml')
  title_list = soup.select('a[class="h_name"]')
  address_list = soup.select('span[class="address]')
  attr_list = soup.select('span[class="attribute"]')
  price_list = soup.find_all(attrs={"class": "xq_aprice xq_esf_width"}) # select对于某些属性值(属性值中间包含空格)无法识别,可以用find_all(attrs={})代替
  for num in range(20):
   tag_tmp_list = []
   try:
    title = title_list[num].attrs["title"]
    print(r'************************正在获取%s************************' % title)
    address = re.sub('\n', '', address_list[num].get_text())
    area = re.search('\d+[\u4E00-\u9FA5]{2}', attr_list[num].get_text()).group(0)
    layout = re.search('\d[^0-9]\d.', attr_list[num].get_text()).group(0)
    floor = re.search('\d/\d', attr_list[num].get_text()).group(0)
    price = re.search('\d+[\u4E00-\u9FA5]', price_list[num].get_text()).group(0)
    unit_price = re.search('\d+[\u4E00-\u9FA5]/.', price_list[num].get_text()).group(0)
    tag_tmp_list = copy.deepcopy(fin_search_list[i][:3])
    for tag in [title, address, area, layout, floor, price, unit_price]:
     tag_tmp_list.append(tag)
    fin_info_list.append(tag_tmp_list)
   except:
    print('【抓取失败】')
    continue
 print('进程%s结束' % process_i)
 return fin_info_list
</div>
四、分配任务,并行抓取
对任务列表进行分片,设置进程池,并行抓取。
# 分配任务
def assignment_search_list(fin_search_list, project_num): # project_num每个进程包含的任务数,数值越小,进程数越多
 assignment_list = []
 fin_search_list_len = len(fin_search_list)
 for i in range(0, fin_search_list_len, project_num):
  start = i
  end = i+project_num
  assignment_list.append(fin_search_list[start: end]) # 获取列表碎片
 return assignment_list
</div>
p = Pool(4) # 设置进程池 assignment_list = assignment_search_list(fin_info_pn_list, 3) # 分配任务,用于多进程 result = [] # 多进程结果列表 for i in range(len(assignment_list)): result.append(p.apply_async(get_info, args=(assignment_list[i], i))) p.close()