

需要用到的包:
beautifulsoup4
html5lib
image
requests
redis
PyMySQL
pip安装所有依赖包:
pip install \
Image \
requests \
beautifulsoup4 \
html5lib \
redis \
PyMySQL
运行环境需要支持中文
测试运行环境python3.5,不保证其他运行环境能完美运行
需要安装mysql和redis
配置 config.ini 文件,设置好mysql和redis,并且填写你的知乎帐号
向数据库导入 init.sql
Run
开始抓取数据: python get_user.py
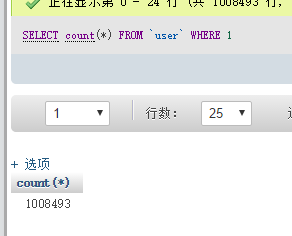
查看抓取数量: python check_redis.py
效果
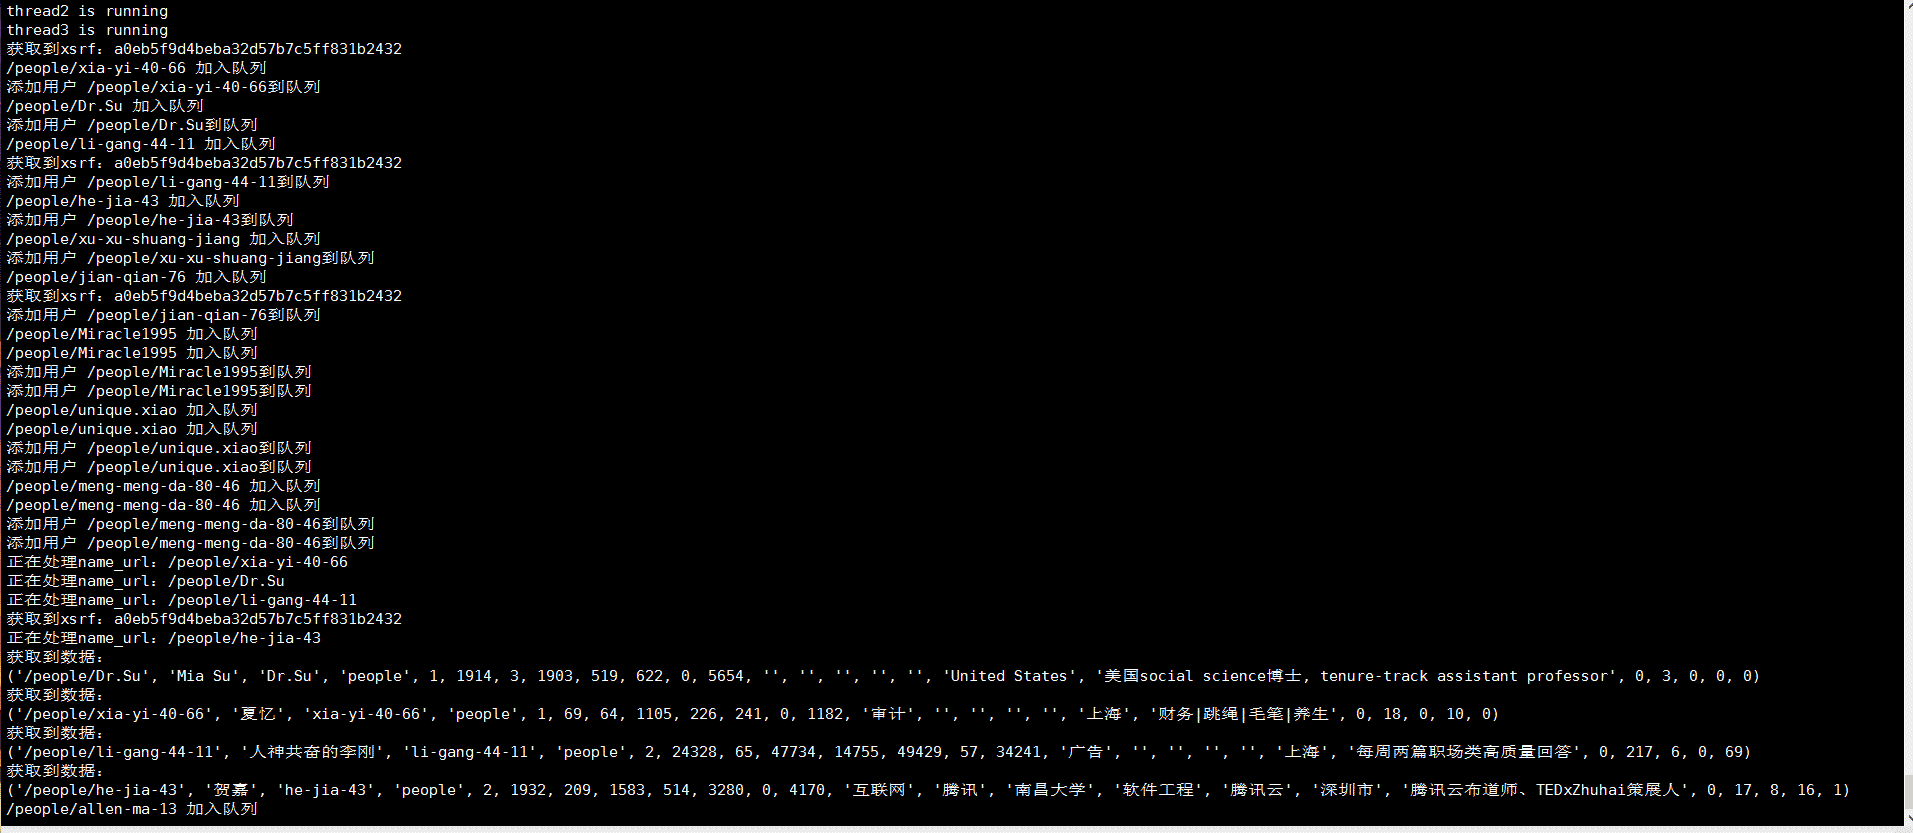
总体思路
1.首先是模拟登陆知乎,利用保存登陆的cookie信息
2.抓取知乎页面的html代码,留待下一步继续进行分析提取信息
3.分析提取页面中用户的个性化url,放入redis(这里特别说明一下redis的思路用法,将提取到的用户的个性化url放入redis的一个名为already_get_user的hash table,表示已抓取的用户,对于已抓取过的用户判断是否存在于already_get_user以去除重复抓取,同时将个性化url放入user_queue的队列中,需要抓取新用户时pop队列获取新的用户)
4.获取用户的关注列表和粉丝列表,继续插入到redis
5.从redis的user_queue队列中获取新用户继续重复步骤3
模拟登陆知乎
首先是登陆,登陆功能作为一个包封装了在login里面,方便整合调用
header部分,这里Connection最好设为close,不然可能会碰到max retireve exceed的错误
原因在于普通的连接是keep-alive的但是却又没有关闭
# http请求的header
headers = {
  "User-Agent": "Mozilla/5.0 (Windows NT 10.0; Win64; x64) AppleWebKit/537.36 (KHTML, like Gecko) Chrome/53.0.2785.143 Safari/537.36",
  "Accept": "text/html,application/xhtml+xml,application/xml;q=0.9,image/webp,*/*;q=0.8",
  "Host": "www.zhihu.com",
  "Referer": "https://www.zhihu.com/",
  "Origin": "https://www.zhihu.com/",
  "Upgrade-Insecure-Requests": "1",
  "Content-Type": "application/x-www-form-urlencoded; charset=UTF-8",
  "Pragma": "no-cache",
  "Accept-Encoding": "gzip, deflate, br",
  'Connection': 'close'
}

# 验证是否登陆
def check_login(self):
  check_url = 'https://www.zhihu.com/settings/profile'
  try:
    login_check = self.__session.get(check_url, headers=self.headers, timeout=35)
  except Exception as err:
    print(traceback.print_exc())
    print(err)
    print("验证登陆失败,请检查网络")
    sys.exit()
  print("验证登陆的http status code为:" + str(login_check.status_code))
  if int(login_check.status_code) == 200:
    return True
  else:
    return False
</div>
进入首页查看http状态码来验证是否登陆,200为已经登陆,一般304就是被重定向所以就是没有登陆
# 获取验证码
def get_captcha(self):
  t = str(time.time() * 1000)
  captcha_url = 'http://www.zhihu.com/captcha.gif?r=' + t + "&type=login"
  r = self.__session.get(captcha_url, headers=self.headers, timeout=35)
  with open('captcha.jpg', 'wb') as f:
    f.write(r.content)
    f.close()
    # 用pillow 的 Image 显示验证码
    # 如果没有安装 pillow 到源代码所在的目录去找到验证码然后手动输入
  '''try:
    im = Image.open('captcha.jpg')
    im.show()
    im.close()
  except:'''
  print(u'请到 %s 目录找到captcha.jpg 手动输入' % os.path.abspath('captcha.jpg'))
  captcha = input("请输入验证码\n>")
  return captcha
</div>
获取验证码的方法。当登录次数太多有可能会要求输入验证码,这里实现这个功能
# 获取xsrf
def get_xsrf(self):
  index_url = 'http://www.zhihu.com'
  # 获取登录时需要用到的_xsrf
  try:
    index_page = self.__session.get(index_url, headers=self.headers, timeout=35)
  except:
    print('获取知乎页面失败,请检查网络连接')
    sys.exit()
  html = index_page.text
  # 这里的_xsrf 返回的是一个list
  BS = BeautifulSoup(html, 'html.parser')
  xsrf_input = BS.find(attrs={'name': '_xsrf'})
  pattern = r'value=\"(.*?)\"'
  print(xsrf_input)
  self.__xsrf = re.findall(pattern, str(xsrf_input))
  return self.__xsrf[0]
</div>
获取xsrf,为什么要获取xsrf呢,因为xsrf是一种防止跨站攻击的手段,具体介绍可以看这里csrf
在获取到xsrf之后把xsrf存入cookie当中,并且在调用api的时候带上xsrf作为头部,不然的话知乎会返回403
# 进行模拟登陆
def do_login(self):
  try:
    # 模拟登陆
    if self.check_login():
      print('您已经登录')
      return
    else:
      if self.config.get("zhihu_account", "username") and self.config.get("zhihu_account", "password"):
        self.username = self.config.get("zhihu_account", "username")
        self.password = self.config.get("zhihu_account", "password")
      else:
        self.username = input('请输入你的用户名\n> ')
        self.password = input("请输入你的密码\n> ")
  except Exception as err:
    print(traceback.print_exc())
    print(err)
    sys.exit()
  if re.match(r"^1\d{10}$", self.username):
    print("手机登陆\n")
    post_url = 'http://www.zhihu.com/login/phone_num'
    postdata = {
      '_xsrf': self.get_xsrf(),
      'password': self.password,
      'remember_me': 'true',
      'phone_num': self.username,
    }
  else:
    print("邮箱登陆\n")
    post_url = 'http://www.zhihu.com/login/email'
    postdata = {
      '_xsrf': self.get_xsrf(),
      'password': self.password,
      'remember_me': 'true',
      'email': self.username,
    }
  try:
    login_page = self.__session.post(post_url, postdata, headers=self.headers, timeout=35)
    login_text = json.loads(login_page.text.encode('latin-1').decode('unicode-escape'))
    print(postdata)
    print(login_text)
    # 需要输入验证码 r = 0为登陆成功代码
    if login_text['r'] == 1:
      sys.exit()
  except:
    postdata['captcha'] = self.get_captcha()
    login_page = self.__session.post(post_url, postdata, headers=self.headers, timeout=35)
    print(json.loads(login_page.text.encode('latin-1').decode('unicode-escape')))
  # 保存登陆cookie
  self.__session.cookies.save()
</div>
这个就是核心的登陆功能啦,非常关键的就是用到了requests库,非常方便的保存到session
我们这里全局都是用单例模式,统一使用同一个requests.session对象进行访问功能,保持登录状态的一致性
最后主要调用登陆的代码为
# 创建login对象
lo = login.login.Login(self.session)
# 模拟登陆
if lo.check_login():
  print('您已经登录')
else:
  if self.config.get("zhihu_account", "username") and self.config.get("zhihu_account", "username"):
    username = self.config.get("zhihu_account", "username")
    password = self.config.get("zhihu_account", "password")
  else:
    username = input('请输入你的用户名\n> ')
    password = input("请输入你的密码\n> ")
  lo.do_login(username, password)
</div>
知乎模拟登陆到此就完成啦
知乎用户抓取
def __init__(self, threadID=1, name=''):
# 多线程
print("线程" + str(threadID) + "初始化")
threading.Thread.__init__(self)
self.threadID = threadID
self.name = name
try:
print("线程" + str(threadID) + "初始化成功")
except Exception as err:
print(err)
print("线程" + str(threadID) + "开启失败")
self.threadLock = threading.Lock()
# 获取配置
self.config = configparser.ConfigParser()
self.config.read("config.ini")
# 初始化session
requests.adapters.DEFAULT_RETRIES = 5
self.session = requests.Session()
self.session.cookies = cookielib.LWPCookieJar(filename='cookie')
self.session.keep_alive = False
try:
self.session.cookies.load(ignore_disca