

背景
中秋的时候,一个朋友给我发了一封邮件,说他在爬链家的时候,发现网页返回的代码都是乱码,让我帮他参谋参谋(中秋加班,真是敬业= =!),其实这个问题我很早就遇到过,之前在爬小说的时候稍微看了一下,不过没当回事,其实这个问题就是对编码的理解不到位导致的。
问题
很普通的一个爬虫代码,代码是这样的:
# ecoding=utf-8
import re
import requests
import sys
reload(sys)
sys.setdefaultencoding('utf8')

url = 'http://jb51.net/ershoufang/rs%E6%8B%9B%E5%95%86%E6%9E%9C%E5%B2%AD/'
res = requests.get(url)
print res.text
</div>
目的其实很简单,就是爬一下链家的内容,但是这样执行之后,返回的结果,所有涉及到中文的内容,全部会变成乱码,比如这样
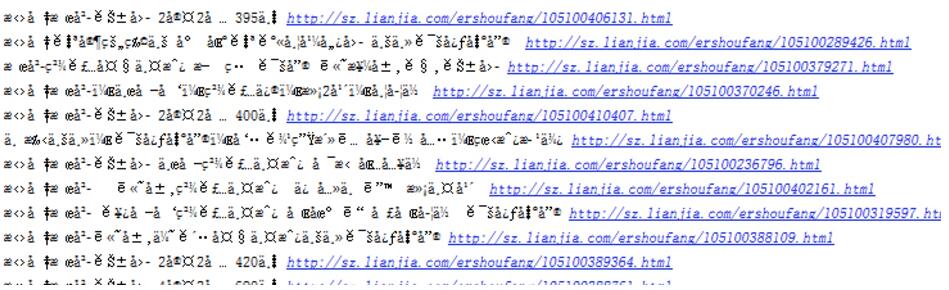
<script type="text/template" id="newAddHouseTpl"> <div class="newAddHouse"> 自从您上次æµè§ˆï¼ˆ<%=time%>)之åŽï¼Œè¯¥æœç´¢æ¡ä»¶ä¸‹æ–°å¢žåŠ 了<%=count%>å¥—æˆ¿æº <a href="<%=url%>" class="LOGNEWERSHOUFANGSHOW" <%=logText%>><%=linkText%></a> <span class="newHouseRightClose">x</span> </div> </script></div>
这样的数据拿来可以说毫无作用。
问题分析
这里的问题很明显了,就是文字的编码不正确,导致了乱码。
查看网页的编码
从爬取的目标网页的头来看,网页是用utf-8来编码的。
<meta http-equiv="Content-Type" content="text/html; charset=utf-8"></div>
所以,最终的编码,我们肯定也要用utf-8来处理,也就是说,最终的文本处理,要用utf-8来解码,也就是:decode('utf-8')
文本的编码解码
Python的编码解码的过程是这样的,源文件 ===》 encode(编码方式) ===》decode(解码方式),在很大的程度上,不推荐使用
import sys
reload(sys)
sys.setdefaultencoding('utf8')
</div>
这种方式来硬处理文字编码。不过在某些时候不影响的情况下,偷偷懒也不是什么大问题,不过比较建议的就是获取源文件之后,使用encode和decode的方式来处理文本。
回到问题
现在问题最大的是源文件的编码方式,我们正常使用requests的时候,它会自动猜源文件的编码方式,然后转码成Unicode的编码,但是,毕竟是程序,是有可能猜错的,所以如果猜错了,我们就需要手工来指定编码方式。官方文档的描述如下:
When you make a request, Requests makes educated guesses about the encoding of the response based on the HTTP headers. The text encoding guessed by Requests is used when you access r.text. You can find out what encoding Requests is using, and change it, using the r.encoding property.
所以我们需要查看requests返回的编码方式到底是什么?
# ecoding=utf-8
import re
import requests
from bs4 import BeautifulSoup
import sys
reload(sys)
sys.setdefaultencoding('utf8')

url = 'http://jb51.net/ershoufang/rs%E6%8B%9B%E5%95%86%E6%9E%9C%E5%B2%AD/'

res = requests.get(url)
print res.encoding
</div>
打印的结果如下:
ISO-8859-1
也就是说,源文件使用的是ISO-8859-1来编码。百度一下ISO-8859-1,结果如下:
ISO8859-1,通常叫做Latin-1。Latin-1包括了书写所有西方欧洲语言不可缺少的附加字符。
问题解决
发现了这个东东,问题就很好解决了,只要指定一下编码,就能正确的打出中文了。代码如下:
# ecoding=utf-8
import requests
import sys
reload(sys)
sys.setdefaultencoding('utf8')

url = 'http://jb51.net/ershoufang/rs%E6%8B%9B%E5%95%86%E6%9E%9C%E5%B2%AD/'

res = requests.get(url)
res.encoding = ('utf8')

print res.text
</div>
打印的结果就很明显,中文都正确的显示出来了。
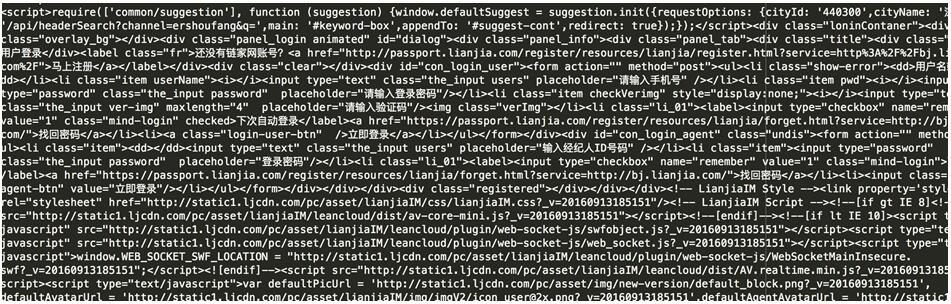
另一种方式是在源文件上做解码和编码,代码如下:
# ecoding=utf-8
import requests
import sys
reload(sys)
sys.setdefaultencoding('utf8')

url = 'http://jb51.net/ershoufang/rs%E6%8B%9B%E5%95%86%E6%9E%9C%E5%B2%AD/'

res = requests.get(url)
# res.encoding = ('utf8')

print res.text.encode('ISO-8859-1').decode('utf-8')
</div>
另:ISO-8859-1也叫做latin1,使用latin1做解码结果也是正常的。
关于字符的编码,很多东西可以说,想了解的朋友可以参考以下大神的资料。
•《The Absolute Minimum Every Software Developer Absolutely, Positively Must Know About Unicode and Character Sets (No Excuses!)》
以上这篇浅谈Python爬取网页的编码处理就是小编分享给大家的全部内容了,希望能给大家一个参考,也希望大家多多支持。
</div>