

网络I/O模型
人多了,就会有问题。web刚出现的时候,光顾的人很少。近年来网络应用规模逐渐扩大,应用的架构也需要随之改变。C10k的问题,让工程师们需要思考服务的性能与应用的并发能力。
网络应用需要处理的无非就是两大类问题,网络I/O,数据计算。相对于后者,网络I/O的延迟,给应用带来的性能瓶颈大于后者。网络I/O的模型大致有如下几种:
- 同步模型(synchronous I/O)
- 阻塞I/O(bloking I/O)
- 非阻塞I/O(non-blocking I/O)
- 多路复用I/O(multiplexing I/O)
- 信号驱动式I/O(signal-driven I/O)
- 异步I/O(asynchronous I/O)
网络I/O的本质是socket的读取,socket在linux系统被抽象为流,I/O可以理解为对流的操作。这个操作又分为两个阶段:
等待流数据准备(wating for the data to be ready)。
从内核向进程复制数据(copying the data from the kernel to the process)。
对于socket流而已,
第一步通常涉及等待网络上的数据分组到达,然后被复制到内核的某个缓冲区。
第二步把数据从内核缓冲区复制到应用进程缓冲区。
I/O模型:
举个简单比喻,来了解这几种模型。网络IO好比钓鱼,等待鱼上钩就是网络中等待数据准备好的过程,鱼上钩了,把鱼拉上岸就是内核复制数据阶段。钓鱼的人就是一个应用进程。
阻塞I/O(bloking I/O)
阻塞I/O是最流行的I/O模型。它符合人们最常见的思考逻辑。阻塞就是进程 "被" 休息, CPU处理其它进程去了。在网络I/O的时候,进程发起recvform系统调用,然后进程就被阻塞了,什么也不干,直到数据准备好,并且将数据从内核复制到用户进程,最后进程再处理数据,在等待数据到处理数据的两个阶段,整个进程都被阻塞。不能处理别的网络I/O。大致如下图:
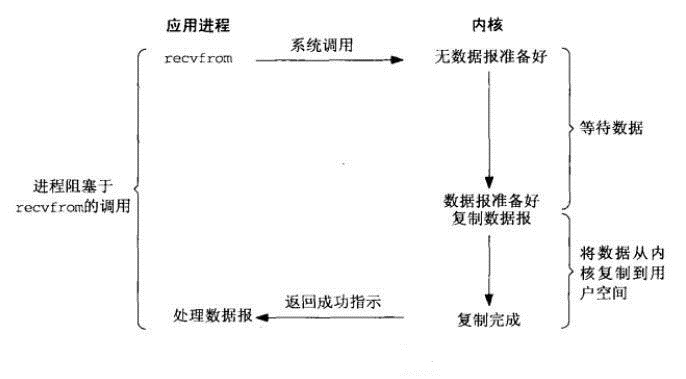
这就好比我们去钓鱼,抛竿之后就一直在岸边等,直到等待鱼上钩。然后再一次抛竿,等待下一条鱼上钩,等待的时候,什么事情也不做,大概会胡思乱想吧。
阻塞IO的特点就是在IO执行的两个阶段都被block了
非阻塞I/O(non-bloking I/O)
在网络I/O时候,非阻塞I/O也会进行recvform系统调用,检查数据是否准备好,与阻塞I/O不一样,"非阻塞将大的整片时间的阻塞分成N多的小的阻塞, 所以进程不断地有机会 '被' CPU光顾"。
也就是说非阻塞的recvform系统调用调用之后,进程并没有被阻塞,内核马上返回给进程,如果数据还没准备好,此时会返回一个error。进程在返回之后,可以干点别的事情,然后再发起recvform系统调用。重复上面的过程,循环往复的进行recvform系统调用。这个过程通常被称之为轮询。轮询检查内核数据,直到数据准备好,再拷贝数据到进程,进行数据处理。需要注意,拷贝数据整个过程,进程仍然是属于阻塞的状态。
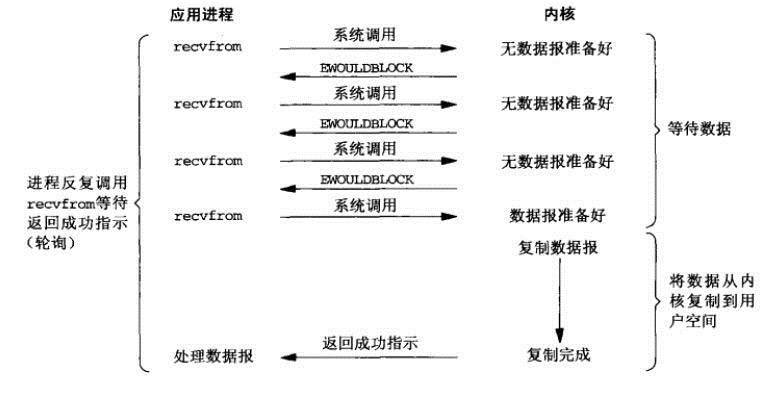
我们再用钓鱼的方式来类别,当我们抛竿入水之后,就看下鱼漂是否有动静,如果没有鱼上钩,就去干点别的事情,比如再挖几条蚯蚓。然后不久又来看看鱼漂是否有鱼上钩。这样往返的检查又离开,直到鱼上钩,再进行处理。
非阻塞 IO的特点是用户进程需要不断的主动询问kernel数据是否准备好。
多路复用I/O(multiplexing I/O)
可以看出,由于非阻塞的调用,轮询占据了很大一部分过程,轮询会消耗大量的CPU时间。结合前面两种模式。如果轮询不是进程的用户态,而是有人帮忙就好了。多路复用正好处理这样的问题。
多路复用有两个特别的系统调用select或poll。select调用是内核级别的,select轮询相对非阻塞的轮询的区别在于---前者可以等待多个socket,当其中任何一个socket的数据准好了,就能返回进行可读,然后进程再进行recvform系统调用,将数据由内核拷贝到用户进程,当然这个过程是阻塞的。多路复用有两种阻塞,select或poll调用之后,会阻塞进程,与第一种阻塞不同在于,此时的select不是等到socket数据全部到达再处理, 而是有了一部分数据就会调用用户进程来处理。如何知道有一部分数据到达了呢?监视的事情交给了内核,内核负责数据到达的处理。也可以理解为"非阻塞"吧。
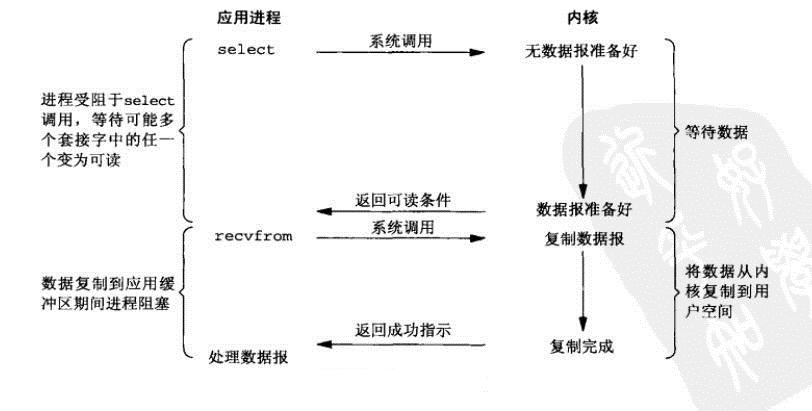
对于多路复用,也就是轮询多个socket。钓鱼的时候,我们雇了一个帮手,他可以同时抛下多个钓鱼竿,任何一杆的鱼一上钩,他就会拉杆。他只负责帮我们钓鱼,并不会帮我们处理,所以我们还得在一帮等着,等他把收杆。我们再处理鱼。多路复用既然可以处理多个I/O,也就带来了新的问题,多个I/O之间的顺序变得不确定了,当然也可以针对不同的编号。
多路复用的特点是通过一种机制一个进程能同时等待IO文件描述符,内核监视这些文件描述符(套接字描述符),其中的任意一个进入读就绪状态,select, poll,epoll函数就可以返回。对于监视的方式,又可以分为 select, poll, epoll三种方式。
了解了前面三种模式,在用户进程进行系统调用的时候,他们在等待数据到来的时候,处理的方式不一样,直接等待,轮询,select或poll轮询,第一个过程有的阻塞,有的不阻塞,有的可以阻塞又可以不阻塞。当时第二个过程都是阻塞的。从整个I/O过程来看,他们都是顺序执行的,因此可以归为同步模型(asynchronous)。都是进程主动向内核检查。
异步I/O(asynchronous I/O)
相对于同步I/O,异步I/O不是顺序执行。用户进程进行aio_read系统调用之后,无论内核数据是否准备好,都会直接返回给用户进程,然后用户态进程可以去做别的事情。等到socket数据准备好了,内核直接复制数据给进程,然后从内核向进程发送通知。I/O两个阶段,进程都是非阻塞的。
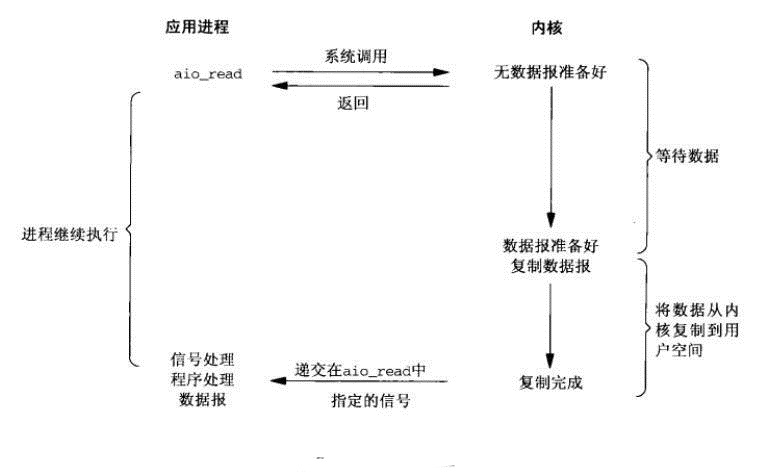
比之前的钓鱼方式不一样,这一次我们雇了一个钓鱼高手。他不仅会钓鱼,还会在鱼上钩之后给我们发短信,通知我们鱼已经准备好了。我们只要委托他去抛竿,然后就能跑去干别的事情了,直到他的短信。我们再回来处理已经上岸的鱼。
同步和异步的区别
通过对上述几种模型的讨论,需要区分阻塞和非阻塞,同步和异步。他们其实是两组概念。区别前一组比较容易,后一种往往容易和前面混合。在我看来,所谓同步就是在整个I/O过程。尤其是拷贝数据的过程是阻塞进程的,并且都是应用进程态去检查内核态。而异步则是整个过程I/O过程用户进程都是非阻塞的,并且当拷贝数据的时是由内核发送通知给用户进程。
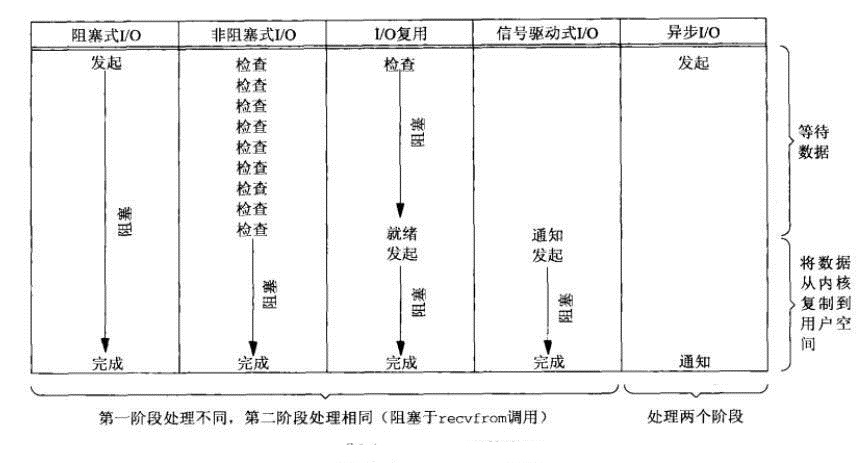
对于同步模型,主要是第一阶段处理方法不一样。而异步模型,两个阶段都不一样。这里我们忽略了信号驱动模式。这几个名词还是容易让人迷惑,只有同步模型才考虑阻塞和非阻塞,因为异步肯定是非阻塞,异步非阻塞的说法感觉画蛇添足。
Select 模型
同步模型中,使用多路复用I/O可以提高服务器的性能。
在多路复用的模型中,比较常用的有select模型和poll模型。这两个都是系统接口,由操作系统提供。当然,Python的select模块进行了更高级的封装。select与poll的底层原理都差不多。千呼万唤始出来,本文的重点select模型。
1.select 原理
网络通信被Unix系统抽象为文件的读写,通常是一个设备,由设备驱动程序提供,驱动可以知道自身的数据是否可用。支持阻塞操作的设备驱动通常会实现一组自身的等待队列,如读/写等待队列用于支持上层(用户层)所需的block或non-block操作。设备的文件的资源如果可用(可读或者可写)则会通知进程,反之则会让进程睡眠,等到数据到来可用的时候,再唤醒进程。
这些设备的文件描述符被放在一个数组中,然后select调用的时候遍历这个数组,如果对于的文件描述符可读则会返回改文件描述符。当遍历结束之后,如果仍然没有一个可用设备文件描述符,select让用户进程则会睡眠,直到等待资源可用的时候在唤醒,遍历之前那个监视的数组。每次遍历都是线性的。
2.select 回显服务器
select涉及系统调用和操作系统相关的知识,因此单从字面上理解其原理还是比较乏味。用代码来演示最好不过了。使用python的select模块很容易写出下面一个回显服务器:
import select
import socket
import sys
HOST = 'localhost'
PORT = 5000
BUFFER_SIZE = 1024
server = socket.socket(socket.AF_INET, socket.SOCK_STREAM)
server.bind((HOST, PORT))
server.listen(5)
inputs = [server, sys.stdin]
running = True
while True:
try:
# 调用 select 函数,阻塞等待
readable, writeable, exceptional = select.select(inputs, [], [])
except select.error, e:
break
# 数据抵达,循环
for sock in readable:
# 建立连接
if sock == server:
conn, addr = server.accept()
# select 监听的socket
inputs.append(conn)
elif sock == sys.stdin:
junk