

在最初学习PYTHON的时候,只知道有DOM和SAX两种解析方法,但是其效率都不够理想,由于需要处理的文件数量太大,这两种方式耗时太高无法接受。
在网络搜索后发现,目前应用比较广泛,且效率相对较高的ElementTree也是一个比较多人推荐的算法,于是拿这个算法来实测对比,ElementTree也包括两种实现,一个是普通ElementTree(ET),一个是ElementTree.iterparse(ET_iter)。
本文将对DOM、SAX、ET、ET_iter四种方式进行横向对比,通过处理相同文件比较各个算法的用时来评估其效率。
程序中将四种解析方法均写为函数,在主程序中分别调用,来评估其解析效率。
解压后的XML文件内容示例为:
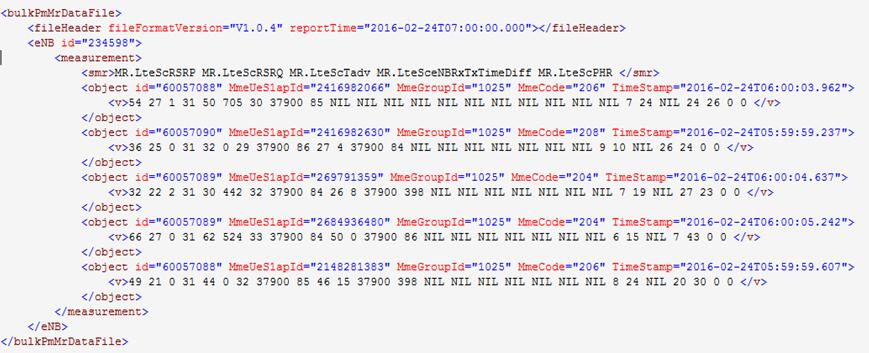
主程序函数调用部分代码为:
  print("文件计数:%d/%d." % (gz_cnt,paser_num))
  str_s,cnt = dom_parser(gz)
  #str_s,cnt = sax_parser(gz)
  #str_s,cnt = ET_parser(gz)
  #str_s,cnt = ET_parser_iter(gz)
  output.write(str_s)
  vs_cnt += cnt
</div>
在最初的函数调用中函数返回两个值,但接收函数调用值时用两个变量分别调用,导致每个函数都要执行两次,之后修改为一次调用两个变量接收返回值,减少了无效调用。
1、DOM解析
函数定义代码:
def dom_parser(gz):
  import gzip,cStringIO
  import xml.dom.minidom

  vs_cnt = 0
  str_s = ''
  file_io = cStringIO.StringIO()
  xm = gzip.open(gz,'rb')
  print("已读入:%s.\n解析中:" % (os.path.abspath(gz)))
  doc = xml.dom.minidom.parseString(xm.read())
  bulkPmMrDataFile = doc.documentElement
  #读入子元素
  enbs = bulkPmMrDataFile.getElementsByTagName("eNB")
  measurements = enbs[0].getElementsByTagName("measurement")
  objects = measurements[0].getElementsByTagName("object")
  #写入csv文件
  for object in objects:
    vs = object.getElementsByTagName("v")
    vs_cnt += len(vs)
    for v in vs:
      file_io.write(enbs[0].getAttribute("id")+' '+object.getAttribute("id")+' '+\
      object.getAttribute("MmeUeS1apId")+' '+object.getAttribute("MmeGroupId")+' '+object.getAttribute("MmeCode")+' '+\
      object.getAttribute("TimeStamp")+' '+v.childNodes[0].data+'\n') #获取文本值
  str_s = (((file_io.getvalue().replace(' \n','\r\n')).replace(' ',',')).replace('T',' ')).replace('NIL','')
  xm.close()
  file_io.close()
  return (str_s,vs_cnt)
</div>
程序运行结果:
**************************************************
程序处理启动。
输入目录为:/tmcdata/mro2csv/input31/。
输出目录为:/tmcdata/mro2csv/output31/。
输入目录下.gz文件个数为:12,本次处理其中的12个。
**************************************************
文件计数:1/12.
已读入:/tmcdata/mro2csv/input31/TD-LTE_MRO_NSN_OMC_234598_20160224060000.xml.gz.
解析中:
文件计数:2/12.
已读入:/tmcdata/mro2csv/input31/TD-LTE_MRO_NSN_OMC_233798_20160224060000.xml.gz.
解析中:
文件计数:3/12.
已读入:/tmcdata/mro2csv/input31/TD-LTE_MRO_NSN_OMC_123798_20160224060000.xml.gz.
解析中:
………………………………………
文件计数:12/12.
已读入:/tmcdata/mro2csv/input31/TD-LTE_MRO_NSN_OMC_235598_20160224060000.xml.gz.
解析中:
VS行计数:177849,运行时间:107.077867,每秒处理行数:1660。
已写入:/tmcdata/mro2csv/output31/mro_0001.csv。
**************************************************
程序处理结束。
由于DOM解析需要将整个文件读入内存,并建立树结构,其内存消耗和时间消耗都比较高,但其优点在于逻辑简单,不需要定义回调函数,便于实现。
2、SAX解析
函数定义代码:
def sax_parser(gz):
  import os,gzip,cStringIO
  from xml.parsers.expat import ParserCreate

  #变量声明
  d_eNB = {}
  d_obj = {}
  s = ''
  global flag
  flag = False
  file_io = cStringIO.StringIO()

  #Sax解析类
  class DefaultSaxHandler(object):
    #处理开始标签
    def start_element(self, name, attrs):
      global d_eNB
      global d_obj
      global vs_cnt
      if name == 'eNB':
        d_eNB = attrs
      elif name == 'object':
        d_obj = attrs
      elif name == 'v':
        file_io.write(d_eNB['id']+' '+ d_obj['id']+' '+d_obj['MmeUeS1apId']+' '+d_obj['MmeGroupId']+' '+d_obj['MmeCode']+' '+d_obj['TimeStamp']+' ')
        vs_cnt += 1
      else:
        pass
    #处理中间文本
    def char_data(self, text):
      global d_eNB
      global d_obj
      global flag
      if text[0:1].isnumeric():
        file_io.write(text)
      elif text[0:17] == 'MR.LteScPlrULQci1':
        flag = True
        #print(text,flag)
      else:
        pass
    #处理结束标签
    def end_element(self, name):
      global d_eNB
      global d_obj
      if name == 'v':
        file_io.write('\n')
      else:
        pass

  #Sax解析调用
  handler = DefaultSaxHandler()
  parser = ParserCreate()
  parser.StartElementHandler = handler.start_element
  parser.EndElementHandler = handler.end_element
  parser.CharacterDataHandler = handler.char_data
  vs_cnt = 0
  str_s = ''
  xm = gzip.open(gz,'rb')
  print("已读入:%s.\n解析中:" % (os.path.abspath(gz)))
  for line in xm.readlines():
    parser.Parse(line) #解析xml文件内容
    if flag:
      break
  str_s = file_io.getvalue().replace(' \n','\r\n').replace(' ',',').replace('T',' ').replace('NIL','')  #写入解析后内容
  xm.close()
  file_io.close()
  return (str_s,vs_cnt)
</div>
程序运行结果:
**************************************************
程序处理启动。
输入目录为:/tmcdata/mro2csv/input31/。
输出目录为:/tmcdata/mro2csv/output31/。
输入目录下.gz文件个数为:12,本次处理其中的12个。
**************************************************
文件计数:1/12.
已读入:/tmcdata/mro2csv/input31/TD-LTE_MRO_NSN_OMC_234598_20160224060000.xml.gz.
解析中:
文件计数:2/12.
已读入:/tmcdata/mro2csv/input31/TD-LTE_MRO_NSN_OMC_233798_20160224060000.xml.gz.
解析中:
文件计数:3/12.
已读入:/tmcdata/mro2csv/input31/TD-LTE_MRO_NSN_OMC_123798_20160224060000.xml.gz.
解析中:
.........................................
文件计数:12/12.
已读入:/tmcdata/mro2csv/input31/TD-LTE_MRO_NSN_OMC_235598_20160224060000.xml.gz.
解析中:
VS行计数:177849,运行时间:14.386779,每秒处理行数:12361。
已写入:/tmcdata/mro2csv/output31/mro_0001.csv。
**************************************************
程序处理结束。
SAX解析相比DOM解析,运行时间大幅缩短,由于SAX采用逐行解析,对于处理较大文件其占用内存也少,因此SAX解析是目前应用较多的一种解析方法。其缺点在于需要自己实现回调函数,逻辑较为复杂。
3、ET解析
函数定义代码:
def ET_parser(gz):
  import os,gzip,cStringIO
  import xml.etree.cElementTree as ET

  vs_cnt = 0
  str_s = ''
  file_io = cStringIO.StringIO()
  xm = gzip.open(gz,'rb')
  print("已读入:%s.\n解析中:" % (os.path.abspath(gz)))
  tree = ET.ElementTree(file=xm)
  root = tree.getroot()
  for elem in root[1][0].findall('object'):
      for v in elem.findall('v'):
          file_io.write(root[1].attrib['id']+' '+elem.attrib['TimeStamp']+' '+elem.attrib['MmeCode']+' '+\
          elem.attrib['id']+' '+ elem.attrib['MmeUeS1apId']+' '+ elem.attrib['MmeGroupId']+' '+ v.text+'\n')
      vs_cnt += 1
  str_s = file_io.getvalue().replace(' \n','\r\n').replace(' ',',').replace('T',' ').replace('NIL','')  #写入解析后内容
  xm.close()
  file_io.close()
  return (str_s,vs_cnt)
</div>
程序运行结果:
**************************************************
程序处理启动。
输入目录为:/tmcdata/mro2csv/input31/。
输出目录为:/tmcdata/mro2csv/output31/。
输入目录下.