

读写中文
需要读取utf-8编码的中文文件,先利用sublime text软件将它改成无DOM的编码,然后用以下代码:
with codecs.open(note_path, 'r+','utf-8') as f:
line=f.readline()
print line
</div>
这样就可以正确地读出文件里面的中文字符了。
同样的,如果要在创建的文件中写入中文,最好也和上面差不多:
with codecs.open(st,'a+','utf-8') as book_note:
book_note.write(st)
</div>
创建中文文件
然后以读出的字符为文件名,创建文件。
如果直接用上面读出来的字符串创建文件,则会出现:
st=digest_path+"\\"+onenote[0]+".txt"
print st
with open(st,'a+') as book_note:
</div>
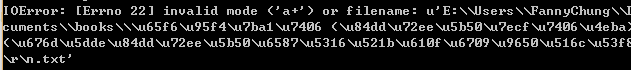
经过调试,应该是最后一个换行符的问题,在生成名字的时候,将字符trip一下,就能够得到文件:
st=digest_path+"\\"+onenote[0].strip()+".txt"</div>
中文编码问题是用中文的程序员经常头大的问题,在python下也是如此,那么应该怎么理解和解决python的编码问题呢?
我们要知道python内部使用的是unicode编码,而外部却要面对千奇百怪的各种编码,比如作为中国程序经常要面对的gbk,gb2312,utf8等,那这些编码是怎么转换成内部的unicode呢?
首先我们先看一下源代码文件中使用字符串的情况。源代码文件作为文本文件就必然是以某种编码形式存储代码的,python默认会认为源代码文件是asci编码,比如说代码中有一个变量赋值:
s1='a'
print s1
</div>
python认为这个'a'就是一个asci编码的字符。在仅仅使用英文字符的情况下一切正常,但是如果用了中文,比如:
s1='哈'
print s1
</div>
这个代码文件被执行时就会出错,就是编码出了问题。python默认将代码文件内容当作asci编码处理,但asci编码中不存在中文,因此抛出异常。
解决问题之道就是要让python知道文件中使用的是什么编码形式,对于中文,可以用的常见编码有utf-8,gbk和gb2312等。只需在代码文件的最前端添加如下:
# -*- coding: utf-8 -*-</div>
这就是告知python我这个文件里的文本是用utf-8编码的,这样,python就会依照utf-8的编码形式解读其中的字符,然后转换成unicode编码内部处理使用。
不过,如果你在Windows控制台下运行此代码的话,虽然程序是执行了,但屏幕上打印出的却不是哈字。这是由于python编码与控制台编码的不一致造成的。Windows下控制台中的编码使用的
是gbk,而在代码中使用的utf-8,python按照utf-8编码打印到gbk编码的控制台下自然就会不一致而不能打印出正确的汉字。
解决办法一个是将源代码的编码也改成gbk,也就是代码第一行改成:
# -*- coding: gbk -*-</div>
另一种方法是保持源码文件的utf-8不变,而是在'哈'前面加个u字,也就是:
s1=u'哈'
print s1
</div>
这样就可以正确打印出'哈'字了。
这里的这个u表示将后面跟的字符串以unicode格式存储。python会根据代码第一行标称的utf-8编码识别代码中的汉字'哈',然后转换成unicode对象。如果我们用type查看一下'哈'的数据类型type(‘哈'),会得到<type ‘str'>,而type(u'哈'),则会得到<type ‘unicode'>,也就是在字符前面加u就表明这是一个unicode对象,这个字会以unicode格式存在于内存中,而如果不加u,表明这仅仅是一个使用某种编码的字符串,编码格式取决于python对源码文件编码的识别,这里就是utf-8。
Python在向控制台输出unicode对象的时候会自动根据输出环境的编码进行转换,但如果输出的不是unicode对象而是普通字符串,则会直接按照字符串的编码输出字符串,从而出现上面的现象。
使用unicode对象的话,除了这样使用u标记,还可以使用unicode类以及字符串的encode和decode方法。
unicode类的构造函数接受一个字符串参数和一个编码参数,将字符串封装为一个unicode,比如在这里,由于我们用的是utf-8编码,所以unicode中的编码参数使用'utf-8′将字符封装为
unicode对象,然后正确输出到控制台:
s1=unicode(‘哈', ‘utf-8′)
print s1
</div>
另外,用decode函数也可以将一个普通字符串转换为unicode对象。很多人都搞不明白python字符串的decode和encode函数都是什么意思。这里简要说明一下。
decode是将普通字符串按照参数中的编码格式进行解析,然后生成对应的unicode对象,比如在这里我们代码用的是utf-8,那么把一个字符串转换为unicode就是如下形式:
s2='哈'.decode(‘utf-8′)</div>
这时,s2就是一个存储了'哈'字的unicode对象,其实就和unicode(‘哈', ‘utf-8′)以及u'哈'是相同的。
那么encode正好就是相反的功能,是将一个unicode对象转换为参数中编码格式的普通字符,比如下面代码:
s3=unicode(‘哈', ‘utf-8′).encode(‘utf-8′)</div>
s3现在又变回了utf-8的'哈'。
</div>