

命令行方式运行Python脚本
在这个章节中,我们将写一些简单的数据库管理脚本。在此之前让我们来复习一下如何通过命令行方式执行Python脚本.
如果Linux 或者OS X的操作系统,需要有执行脚本的权限。例如:
chmod a+x script.py</div>
该脚本有个指向使用解释器的命令行。再脚本赋予执行权限后就可以通过命令行执行,就像这样: like this:
./script.py <arguments></div>
然而,在Windows系统上这样做是不行的,你必须提供Python解释器作为必选参数,如:
为了避免Python解释器路径输入出错,你可以将你的文件夹microoblog/flask/Scripts添加到系统路径,确保能正常显示Python解释器。
从现在开始,在Linux/OS X上的语句简洁。如果你使用Windows系统请记得转换语句。
在Flask使用数据库
我们将使用Flask-SQLAlchemy 的扩展来管理数据库。由SQLAlchemy项目提供的,已封装了关系对象映射(ORM)的一个插件。
ORMs允许数据库程序用对象的方式替代表和SQL语句。面向对象的操作被ORM转化为数据库命令。这样就意味着,不用sql语句,让Flask-SQLAlchemy为我们执行sql语句。
迁移
大多数数据库教程都覆盖了创建和使用一个数据库的方法,但是没有充分解决当应用程序扩展时数据库更新的问题。通常,你会删除旧的数据库,然后再创建一个新的数据库来达到更新的效果,这样就丢失了所有的数据。如果这些数据创建起来很费劲,那么我们不得不写导入导出的脚本了。
幸运的是,我们有了更好的方案.
我们现在可以使用SQLAlchemy-migrate做数据库迁移的更新了,虽然它增加了数据库启动时的负担,但这点小小的代价还是值得的,毕竟我们不用担心手动迁移数据库的问题了。
理论学习完毕,我们开始吧!
配置
我们的小程序使用sqlite数据库。sqlite是小程序数据库的最佳选择,一个可以以单文件存储的数据库。
在我们的配置文件中添加新的配置项 (fileconfig.py):
import os
basedir = os.path.abspath(os.path.dirname(__file__))

SQLALCHEMY_DATABASE_URI = 'sqlite:///' + os.path.join(basedir, 'app.db')
SQLALCHEMY_MIGRATE_REPO = os.path.join(basedir, 'db_repository')
</div>
SQLALCHEMY_DATABASE_URI是the Flask-SQLAlchemy必需的扩展。这是我们的数据库文件的路径。
SQLALCHEMY_MIGRATE_REPO 是用来存储SQLAlchemy-migrate数据库文件的文件夹。
最后,初始化应用的时候也需要初始化数据库。这里是升级后的init文件(fileapp/__init):
from flask import Flask
from flask.ext.sqlalchemy import SQLAlchemy

app = Flask(__name__)
app.config.from_object('config')
db = SQLAlchemy(app)

from app import views, models
</div>
注意生成的脚本已改动2个地方。我们现在开始创建数据库的adb对象,引用新的模块。马上来写这个模块。
数据库模型
我们在数据库存储的数据通过数据库model层被映射为一些类里面的对象,ORM层将根据类对象映射到数据库对应的字段.
让我们来创建个映射到users的model。使用WWW SQL Designer工具,我们创建了代表users表的一个图标:
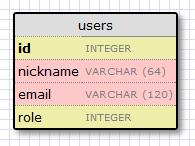
id字段通常作为主键的形式用在所有的models里面,每个在数据库中的user都有一个指定的唯一id值。幸运的是,这些都是自动的,我们只需要提供一个id字段。
nickname和email字段被定义为string类型,他们的长度也已经被指定,这样可以节省数据库存储空间。
role字段被定义为integer类型,我们用来标识users是admins还是其他类型。
现在我们已经明确了users表的结构,接下来转换为编码的工作将相当简单了(fileapp/models.py):
from app import db

ROLE_USER = 0
ROLE_ADMIN = 1

class User(db.Model):
  id = db.Column(db.Integer, primary_key = True)
  nickname = db.Column(db.String(64), index = True, unique = True)
  email = db.Column(db.String(120), index = True, unique = True)
  role = db.Column(db.SmallInteger, default = ROLE_USER)

  def __repr__(self):
    return '<User %r>' % (self.nickname)
</div>
User类把我们刚刚创建的几个字段定义为类变量。字段使用db.Column类创建实例,字段的类型作为参数,另外还提供一些其他可选参数。例如,标识字段唯一性和索引的参数.
__repr__方法告诉Python如何打印class对象,方便我们调试使用。
创建数据库
把配置和model放到正确的目录位置,现在我们创建数据库文件。SQLAlchemy-migrate包自带命令行工具和APIs来创建数据库,这样的方式可以方便以后更新。但是我觉得使用这个命令行工具有些别扭,所以我自己写了个python脚本来调用迁移的APIs.
这里有个创建数据库的脚本 (filedb_create.py):
#!flask/bin/python
from migrate.versioning import api
from config import SQLALCHEMY_DATABASE_URI
from config import SQLALCHEMY_MIGRATE_REPO
from app import db
import os.path
db.create_all()
if not os.path.exists(SQLALCHEMY_MIGRATE_REPO):
  api.create(SQLALCHEMY_MIGRATE_REPO, 'database repository')
  api.version_control(SQLALCHEMY_DATABASE_URI, SQLALCHEMY_MIGRATE_REPO)
else:
  api.version_control(SQLALCHEMY_DATABASE_URI, SQLALCHEMY_MIGRATE_REPO, api.version(SQLALCHEMY_MIGRATE_REPO))
</div>
注意这个脚本是完全通用的,所有的应用路径名都是从配置文件读取的。当你用在自己的项目时,你可以把脚本拷贝到你app`s目录下就能正常使用了。
创建数据库你只需要运行下面的一条命令(注意windows下稍微有些不同):
./db_create.py</div>
运行这条命令之后,你就创建了一个新的app.db文件。这是个支持迁移的空sqlite数据库,同时也会生成一个带有几个文件的db_repository目录,这是SQLAlchemy-migrate存储数据库文件的地方,注意如果数据库已存在它就不会再重新生成了。这将帮助我们在丢失了现有的数据库后,再次自动创建出来。.
第一次迁移
既然我们已经定义好了model,也把它和数据库做了关联,接下来我们来初次尝试下做一个改变应用数据库结构的一次迁移,这将帮助我们从一个空的数据库变成一个可以存储users信息的数据库。
做一个迁移我使用另一个Python小助手脚本 (filedb_migrate.py):
#!flask/bin/python
import imp
from migrate.versioning import api
from app import db
from config import SQLALCHEMY_DATABASE_URI
from config import SQLALCHEMY_MIGRATE_REPO
migration = SQLALCHEMY_MIGRATE_REPO + '/versions/%03d_migration.py' % (api.db_version(SQLALCHEMY_DATABASE_URI, SQLALCHEMY_MIGRATE_REPO) + 1)
tmp_module = imp.new_module('old_model')
old_model = api.create_model(SQLALCHEMY_DATABASE_URI, SQLALCHEMY_MIGRATE_REPO)
exec old_model in tmp_module.__dict__
script = api.make_update_script_for_model(SQLALCHEMY_DATABASE_URI, SQLALCHEMY_MIGRATE_REPO, tmp_module.meta, db.metadata)
open(migration, "wt").write(script)
a = api.upgrade(SQLALCHEMY_DATABASE_URI, SQLALCHEMY_MIGRATE_REPO)
print 'New migration saved as ' + migration
print 'Current database version: ' + str(api.db_version(SQLALCHEMY_DATABASE_URI, SQLALCHEMY_MIGRATE_REPO))
</div>
这个脚本看起来很复杂,其实做的东西真不多。SQLAlchemy-migrate通过对比数据库的结构(从app.db文件读取)和models结构(从app/models.py文件读取)的方式来创建迁移任务,两者之间的差异将作为一个迁移脚本记录在迁移库中,迁移脚本知道如何应用或者撤销一次迁移,所以它可以方便的升级或者降级一个数据库的格式。
虽然我使用上面的脚本自动生成迁移时没遇到什么问
您可能想查找下面的文章:
- 使用Python的Flask框架表单插件Flask-WTF实现Web登录验证
- Python的Flask框架标配模板引擎Jinja2的使用教程
- Python的Flask框架及Nginx实现静态文件访问限制功能
- Python的Flask框架中使用Flask-SQLAlchemy管理数据库的教程
- 详解Python的Flask框架中的signals信号机制
- Flask的图形化管理界面搭建框架Flask-Admin的使用教程
- Python的Flask框架中集成CKeditor富文本编辑器的教程
- Flask框架中密码的加盐哈希加密和验证功能的用法详解
- Python的Flask框架应用程序实现使用QQ账号登录的方法
- Python的Flask框架中使用Flask-Migrate扩展迁移数据库的教程