

协同过滤
在 用户 —— 物品(user - item)的数据关系下很容易收集到一些偏好信息(preference),比如评分。利用这些分散的偏好信息,基于其背后可能存在的关联性,来为用户推荐物品的方法,便是协同过滤,或称协作型过滤(collaborative filtering)。
这种过滤算法的有效性基础在于:
用户的偏好具有相似性,即用户是可分类的。这种分类的特征越明显,推荐的准确率就越高
物品之间是存在关系的,即偏好某一物品的任何人,都很可能也同时偏好另一件物品
不同环境下这两种理论的有效性也不同,应用时需做相应调整。如豆瓣上的文艺作品,用户对其的偏好程度与用户自身的品位关联性较强;而对于电子商务网站来说,商品之间的内在联系对用户的购买行为影响更为显著。当用在推荐上,这两种方向也被称为基于用户的和基于物品的。本文内容为基于用户的。
影评推荐实例
本文主要内容为基于用户偏好的相似性进行物品推荐,使用的数据集为 GroupLens Research 采集的一组从 20 世纪 90 年代末到 21 世纪初由 MovieLens 用户提供的电影评分数据。数据中包含了约 6000 名用户对约 4000 部电影的 100万条评分,五分制。数据包可以从网上下载到,里面包含了三个数据表——users、movies、ratings。因为本文的主题是基于用户偏好的,所以只使用 ratings 这一个文件。另两个文件里分别包含用户和电影的元信息。
本文使用的数据分析包为 pandas,环境为 IPython,因此其实还默认携带了 Numpy 和 matplotlib。下面代码中的提示符看起来不是 IPython 环境是因为 Idle 的格式发在博客上更好看一些。
数据规整
首先将评分数据从 ratings.dat 中读出到一个 DataFrame 里:
>>> import pandas as pd
>>> from pandas import Series,DataFrame
>>> rnames = ['user_id','movie_id','rating','timestamp']
>>> ratings = pd.read_table(r'ratings.dat',sep='::',header=None,names=rnames)
>>> ratings[:3]
 user_id movie_id rating timestamp
0  1  1193  5 978300760
1  1  661  3 978302109
2  1  914  3 978301968

[3 rows x 4 columns]
</div>
ratings 表中对我们有用的仅是 user_id、movie_id 和 rating 这三列,因此我们将这三列取出,放到一个以 user 为行,movie 为列,rating 为值的表 data 里面。(其实将 user 与 movie 的行列关系对调是更加科学的方法,但因为重跑一遍太麻烦了,这里就没改。)
>>> data = ratings.pivot(index='user_id',columns='movie_id',values='rating')
>>> data[:5]
movie_id 1 2 3 4 5 6
user_id
1   5 NaN NaN NaN NaN NaN ...
2  NaN NaN NaN NaN NaN NaN ...
3  NaN NaN NaN NaN NaN NaN ...
4  NaN NaN NaN NaN NaN NaN ...
5  NaN NaN NaN NaN NaN 2 ...
</div>
可以看到这个表相当得稀疏,填充率大约只有 5%,接下来要实现推荐的第一步是计算 user 之间的相关系数,DataFrame 对象有一个很亲切的 .corr(method='pearson', min_periods=1) 方法,可以对所有列互相计算相关系数。method 默认为皮尔逊相关系数,这个 ok,我们就用这个。问题仅在于那个 min_periods 参数,这个参数的作用是设定计算相关系数时的最小样本量,低于此值的一对列将不进行运算。这个值的取舍关系到相关系数计算的准确性,因此有必要先来确定一下这个参数。
相关系数是用于评价两个变量间线性关系的一个值,取值范围为 [-1, 1],-1代表负相关,0 代表不相关,1 代表正相关。其中 0~0.1 一般被认为是弱相关,0.1~0.4 为相关,0.4~1 为强相关。
min_periods 参数测定
测定这样一个参数的基本方法为统计在 min_periods 取不同值时,相关系数的标准差大小,越小越好;但同时又要考虑到,我们的样本空间十分稀疏,min_periods 定得太高会导致出来的结果集太小,所以只能选定一个折中的值。
这里我们测定评分系统标准差的方法为:在 data 中挑选一对重叠评分最多的用户,用他们之间的相关系数的标准差去对整体标准差做点估计。在此前提下对这一对用户在不同样本量下的相关系数进行统计,观察其标准差变化。
首先,要找出重叠评分最多的一对用户。我们新建一个以 user 为行列的方阵 foo,然后挨个填充不同用户间重叠评分的个数:
>>> foo = DataFrame(np.empty((len(data.index),len(data.index)),dtype=int),index=data.index,columns=data.index)
>>> for i in foo.index:
  for j in foo.columns:
   foo.ix[i,j] = data.ix[i][data.ix[j].notnull()].dropna().count()
</div>
这段代码特别费时间,因为最后一行语句要执行 4000*4000 = 1600万遍;(其中有一半是重复运算,因为 foo 这个方阵是对称的)还有一个原因是 Python 的 GIL,使得其只能使用一个 CPU 线程。我在它执行了一个小时后,忍不住去测试了一下总时间,发现要三个多小时后就果断 Ctrl + C 了,在算了一小半的 foo 中,我找到的最大值所对应的行列分别为 424 和 4169,这两位用户之间的重叠评分数为 998:
>>> for i in foo.index:
  foo.ix[i,i]=0#先把对角线的值设为 0

>>> ser = Series(np.zeros(len(foo.index)))
>>> for i in foo.index:
  ser[i]=foo[i].max()#计算每行中的最大值

>>> ser.idxmax()#返回 ser 的最大值所在的行号
4169

>>> ser[4169]#取得最大值
998

>>> foo[foo==998][4169].dropna()#取得另一个 user_id
424  4169
Name: user_id, dtype: float64
</div>
我们把 424 和 4169 的评分数据单独拿出来,放到一个名为 test 的表里,另外计算了一下这两个用户之间的相关系数为 0.456,还算不错,另外通过柱状图了解一下他俩的评分分布情况:
>>> data.ix[4169].corr(data.ix[424])
0.45663851303413217
>>> test = data.reindex([424,4169],columns=data.ix[4169][data.ix[424].notnull()].dropna().index)
>>> test
movie_id 2  6  10 11 12 17 ...
424    4  4  4  4  1  5 ...
4169    3  4  4  4  2  5 ...

>>> test.ix[424].value_counts(sort=False).plot(kind='bar')
>>> test.ix[4169].value_counts(sort=False).plot(kind='bar')
</div>
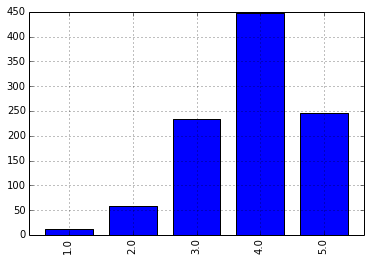
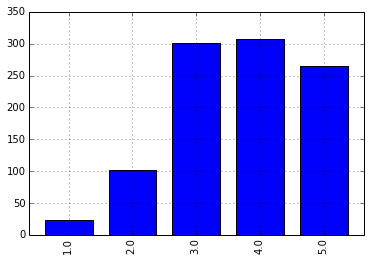
对这俩用户的相关系数统计,我们分别随机抽取 20、50、100、200、500 和 998 个样本值,各抽 20 次。并统计结果:
 >>> periods_test = DataFrame(np.zeros((20,7)),columns=[10,20,50,100,200,500,998])
>>> for i in periods_test.index:
  for j in periods_test.columns:
   sample = test.reindex(columns=np.random.permutation(test.columns)[:j])
   periods_test.ix[i,j] = sample.iloc[0].corr(sample.iloc[1])


>>> periods_test[:5]
  10  20  50  100  200  500  998
0 -0.306719 0.709073 0.504374 0.376921 0.477140 0.426938 0.456639
1 0.386658 0.607569 0.434761 0.471930 0.437222 0.430765 0.456639
2 0.507415 0.585808 0.440619 0.634782 0.490574 0.436799 0.456639
3 0.628112 0.628281 0.452331 0.380073 0.472045 0.444222 0.456639
4 0.792533 0.641503 0.444989 0.499253 0.426420 0.441292 0.456639

[5 rows x 7 columns]
>>> periods_test.describe()
    10   20   50   100  200  500 #998略
count 20.000000 20.000000 20.000000 20.000000 20.000000 20.000000
mean 0.346810 0.464726 0.458866 0.450155 0.467559 0.452448
std  0.398553 0.181743 0.103820 0.093663 0.036439 0.029758
min -0.444302 0.087370 0.192391 0.242112 0.412291 0.399875
25%  0.174531 0.320941 0.434744 0.375643 0.439228 0.435290
50%  0.487157 0.525217 0.476653 0.468850 0.472562 0.443772
75%  0.638685 0.616643 0.519827 0.500825 0.487389 0.465787
max  0.850963 0.709073 0.592040 0.634782 0.546001 0.513486

[8 rows x 7 columns]
</div>
从 std 这一行来看,理想的 min_periods 参数值应当为 200 左右。可能有人会觉得 200 太大了,这个推荐算法对新用户简直没意义。但是得说,随便算出个有超大误差的相关系数,然后拿去做不靠谱的推荐,又有什么意义呢。
算法检验
为了确认在 min_periods=200 下本推荐算法的靠谱程度,最好还是先做个检验。具体方法为:在评价数大于 200 的用户中随机抽取 1000 位用户,每人随机提取一个评价另存到一个数组里,并在数据表中删除这个评价。然后基于