

动机
我们花费大量的时间将数据从普通的交换格式(比如CSV),迁移到像数组、数据库或者二进制存储等高效的计算格式。更糟糕的是,许多人没有将数据迁移到高效的格式,因为他们不知道怎么(或者不能)为他们的工具管理特定的迁移方法。
你所选择的数据格式很重要,它会强烈地影响程序性能(经验规律表明会有10倍的差距),以及那些轻易使用和理解你数据的人。
当提倡Blaze项目时,我经常说:“Blaze能帮助你查询各种格式的数据。”这实际上是假设你能够将数据转换成指定的格式。
进入into项目
into函数能在各种数据格式之间高效的迁移数据。这里的数据格式既包括内存中的数据结构,比如:
列表、集合、元组、迭代器、numpy中的ndarray、pandas中的DataFrame、dynd中的array,以及上述各类的流式序列。
也包括存在于Python程序之外的持久化数据,比如:
CSV、JSON、行定界的JSON,以及以上各类的远程版本
HDF5 (标准格式与Pandas格式皆可)、 BColz、 SAS、 SQL 数据库 ( SQLAlchemy支持的皆可)、 Mongo
into项目能在上述数据格式的任意两个格式之间高效的迁移数据,其原理是利用一个成对转换的网络(该文章底部有直观的解释)。
如何使用它
into函数有两个参数:source和target。它将数据从source转换成target。source和target能够使用如下的格式:
Target Source Example
Object Object A particular DataFrame or list
String String ‘file.csv', ‘postgresql://hostname::tablename'
Type Like list or pd.DataFrame
所以,下边是对into函数的合法调用:
>>> into(list, df) # create new list from Pandas DataFrame

>>> into([], df) # append onto existing list

>>> into('myfile.json', df) # Dump dataframe to line-delimited JSON

>>> into(Iterator, 'myfiles.*.csv') # Stream through many CSV files

>>> into('postgresql://hostname::tablename', df) # Migrate dataframe to Postgres

>>> into('postgresql://hostname::tablename', 'myfile.*.csv') # Load CSVs to Postgres

>>> into('myfile.json', 'postgresql://hostname::tablename') # Dump Postgres to JSON

>>> into(pd.DataFrame, 'mongodb://hostname/db::collection') # Dump Mongo to DataFrame
</div>
Note that into is a single function. We're used to doing this with various to_csv, from_sql methods on various types. The into api is very small; Here is what you need in order to get started:
注意,into函数是一个单一的函数。虽然我们习惯于在各种类型上使用to_csv, from_sql等方法来完成这样的功能,但接口into非常简单。开始使用into函数前,你需要:
$ pip install into

>>> from into import into
</div>
在Github上查看into工程。
实例
现在我们展示一些更深层次的相同的实例。
将Python中的list类型转换成numpy中的array类型
>>> import numpy as np

>>> into(np.ndarray, [1, 2, 3])

array([1, 2, 3])
</div>
加载CSV文件,并转换成Python中的list类型
>>> into(list, 'accounts.csv')

[(1, 'Alice', 100),

(2, 'Bob', 200),

(3, 'Charlie', 300),

(4, 'Denis', 400),

(5, 'Edith', 500)]
</div>
将CSV文件转换成JSON格式
>>> into('accounts.json', 'accounts.csv')

$ head accounts.json

{"balance": 100, "id": 1, "name": "Alice"}

{"balance": 200, "id": 2, "name": "Bob"}

{"balance": 300, "id": 3, "name": "Charlie"}

{"balance": 400, "id": 4, "name": "Denis"}

{"balance": 500, "id": 5, "name": "Edith"}
</div>
将行定界的JSON格式转换成Pandas中的DataFrame格式
>>> import pandas as pd

>>> into(pd.DataFrame, 'accounts.json')

balance id name

0 100 1 Alice

1 200 2 Bob

2 300 3 Charlie

3 400 4 Denis

4 500 5 Edith
</div>
它是如何工作的?
格式转换是有挑战性的。任意两个数据格式之间的健壮、高效的格式转换,都充满了特殊情况和奇怪的库。常见的解决方案是通过一个通用格式,例如DataFrame或流内存列表、字典等,进行格式转换。(见dat)或者通过序列化格式,例如ProtoBuf或Thrift,进行格式转换。这些都是很好的选择,往往也是你想要的。然而有时候这样的转换是比较慢的,特别是当你在实时计算系统上转换,或面对苛刻的存储解决方案时。
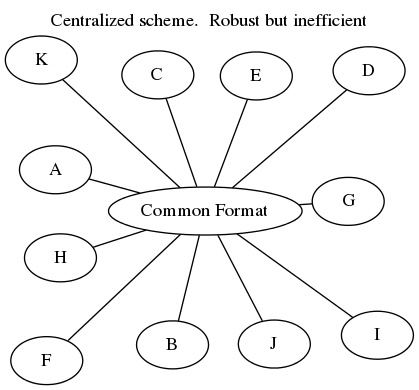
考虑一个例子,在numpy.recarray和pandas.DataFrame之间进行数据迁移。我们可以非常快速地,适当地迁移这些数据。数据的字节不需要更改,只更改其周围的元数据即可。我们不需要将数据序列化到一个交换格式,或转换为中间的纯Python对象。
考虑从CSV文件迁移数据到一个PostgreSQL数据库。通过SQLAlchemy(注:一个Python环境下的数据库工具箱)使用Python迭代器,我们的迁移速度不太可能超过每秒2000条记录。然而使用PostgreSQL自带的CSV加载器,我们的迁移速度可以超过每秒50000条记录。花费一整晚的时间和花费一杯咖啡的时间进行数据迁移,是有很大区别的。然而这需要我们在特殊情况下,能足够灵活的使用特殊代码。
专门的两两互换工具往往比通用解决方案快一个数量级。
Into项目是那些成对地数据迁移组成的一个网络。我们利用下图展示这个网络:
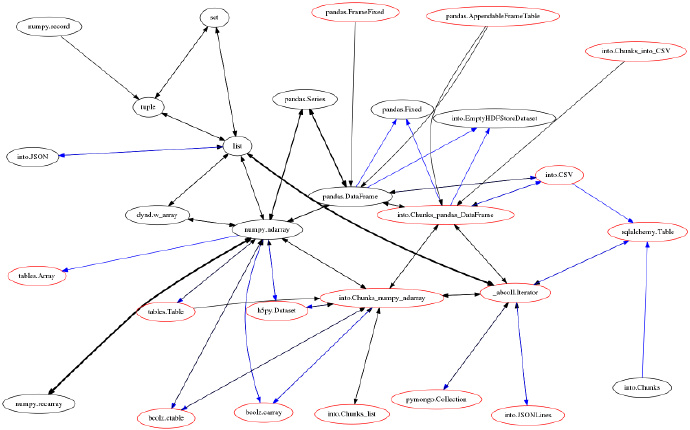
每个节点是一种数据格式。每个定向的边是一个在两种数据格式之间转换数据的函数。into函数的一个调用,可能会遍历多个边和多个中间格式。例如,当我们将CSV文件迁移到Mongo数据库时,我们可以采取以下路径:
?将CSV文件加载到DataFrame中(利用pandas.read_csv)
?然后转换为np.recarray(利用DataFrame.to_records)
?接着转换为一个Python的迭代器类型(利用np.ndarray.tolist)
?最终转换成Mongo中的数据(利用pymongo.Collection.insert)
或者我们可以使用MongoDB自带的CSV加载器,编写一个特殊函数,用一个从CSV到Mongo的定向边缩短整个处理过程。
为了找到最有效的路线,我们利用相对成本(引入权重的ad-hoc)给这个网络的所有边赋予权重值。然后我们使用networkx找到最短路径,进而进行数据迁移。如果某个边由于某种原因失败了(引发NotImplementedError),我们可以自动重新寻找路径。这样我们的迁移方法是既高效又健壮的。
注意,我们给某些节点涂上红色。这些节点的数据量可以大于内存。当我们在两个红色节点之间进行数据迁移时(输入和输出的数据量都可能大于内存),我们限制我们的路径始终在红色子图中,以确保迁移路径中间的数据不会溢出。需要注意的一种格式是chunks(…),例如chunks(DataFrame)是一个可迭代的,在内存中的DataFrames。这个方便的元格式允许我们在大数据上使用紧凑的数据结构,例如numpy的arrays和pandas的DataFrames,同时保持在内存中数据的只有几十兆字节。
这种网络化的方法允许开发者对于特殊情况编写专门的代码,同时确信这段代码只在正确的情况下使用。这种方法允许我们利用一个独立的、可分离的方式处理一个非常复杂的问题。中央调度系统让我们保持头脑清醒。
历史
很久以前,我写过into链接到Blaze的文章,然后我立即就沉默了。这是因为旧的实现方法(网络方法之前)很难扩展或维护,也没有准备好进入其黄金期。
我很满意这个网络。意想不到的应用程序经常能够正常运行,into工程现在也准备好进入其黄金期了。Into工程可以通过conda和pip得到,而独立于Blaze。它主要的依赖为NumPy、Pandas和NetworkX,所以对于阅读我博客的大部分人来说,它算是相对轻量