

python解析网页,无出BeautifulSoup左右,此是序言
安装
BeautifulSoup4以后的安装需要用eazy_install,如果不需要最新的功能,安装版本3就够了,千万别以为老版本就怎么怎么不好,想当初也是千万人在用的啊。安装很简单
$ wget "http://www.crummy.com/software/BeautifulSoup/download/3.x/BeautifulSoup-3.2.1.tar.gz"
$ tar zxvf BeautifulSoup-3.2.1.tar.gz
</div>
然后把里面的BeautifulSoup.py这个文件放到你python安装目录下的site-packages目录下
site-packages是存放Python第三方包的地方,至于这个目录在什么地方呢,每个系统不一样,可以用下面的方式找一下,基本上都能找到
$ sudo find / -name "site-packages" -maxdepth 5 -type d
$ find ~ -name "site-packages" -maxdepth 5
</div>
当然如果没有root权限就查找当前用户的根目录
$ find ~ -name "site-packages" -maxdepth 5 -type d
</div>
如果你用的是Mac,哈哈,你有福了,我可以直接告诉你,Mac的这个目录在/Library/Python/下,这个下面可能会有多个版本的目录,没关系,放在最新的一个版本下的site-packages就行了。使用之前先import一下
from BeautifulSoup import BeautifulSoup
</div>
使用
在使用之前我们先来看一个实例
现在给你这样一个页面
http://movie.douban.com/tag/%E5%96%9C%E5%89%A7
</div>
它是豆瓣电影分类下的喜剧电影,如果让你找出里面评分最高的100部,该怎么做呢
好了,我先晒一下我做的,鉴于本人在CSS方面处于小白阶段以及天生没有美术细菌,界面做的也就将就能看下,别吐
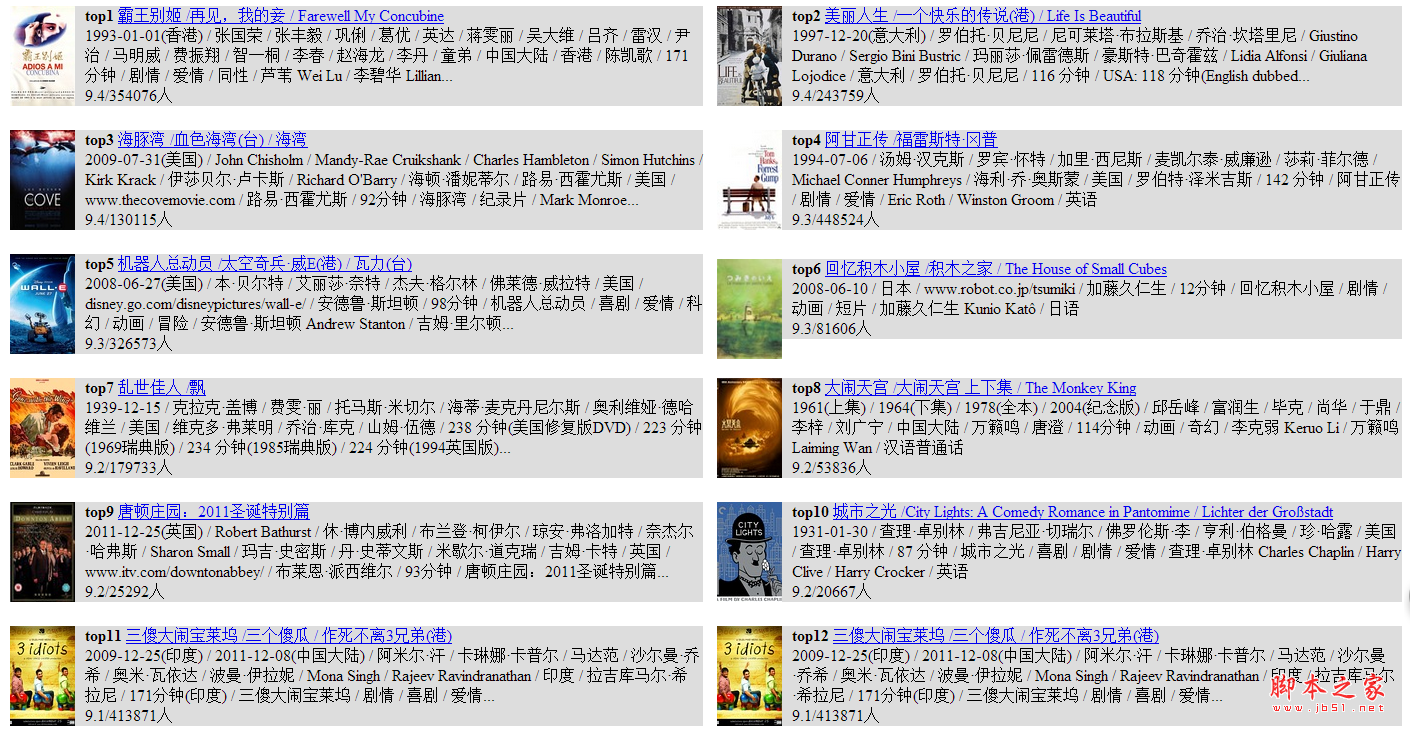
接下来我们开始学习BeautifulSoup的一些基本方法,做出上面那个页面就易如反掌了
鉴于豆瓣那个页面比较复杂,我们先以一个简单样例来举例,假设我们处理如下的网页代码
<html>
<head><title>Page title</title></head>
<body>
<p id="firstpara" align="center">
This is paragraph
<b>
one
</b>
.
</p>
<p id="secondpara" align="blah">
This is paragraph
<b>
two
</b>
.
</p>
</body>
</html>
</div>
你没看错,这就是官方文档里的一个样例,如果你有耐心,看官方文档就足够了,后面的你都不用看
http://www.leeon.me/upload/other/beautifulsoup-documentation-zh.html
初始化
首先将上面的HTML代码赋给一个变量html如下,为了方便大家复制这里贴的是不带回车的,上面带回车的代码可以让大家看清楚HTML结构
html = '<html><head><title>Page title</title></head><body><p id="firstpara" align="center">This is paragraph<b>one</b>.</p><p id="secondpara" align="blah">This is paragraph<b>two</b>.</p></body></html>'
</div>
初始化如下:
soup = BeautifulSoup(html)
</div>
我们知道HTML代码可以看成一棵树,这个操作等于是把HTML代码解析成一种树型的数据结构并存储在soup中,注意这个数据结构的根节点不是<html>,而是soup,其中html标签是soup的唯一子节点,不信你试试下面的操作
print soup
print soup.contents[0]
print soup.contents[1]
</div>
前两个输出结果是一致的,就是整个html文档,第三条输出报错IndexError: list index out of range
查找节点
查找节点有两种反回形式,一种是返回单个节点,一种是返回节点list,对应的查找函数分别为find和findAll
单个节点
1.根据节点名
## 查找head节点
print soup.find('head') ## 输出为<head><title>Page title</title></head>
## or
## head = soup.head
</div>
这种方式查找到的是待查找节点最近的节点,比如这里待查找节点是soup,这里找到的是离soup最近的一个head(如果有多个的话)
2.根据属性
## 查找id属性为firstpara的节点
print soup.find(attrs={'id':'firstpara'})
## 输出为<p id="firstpara" align="center">This is paragraph<b>one</b>.</p>
## 也可节点名和属性进行组合
print soup.find('p', attrs={'id':'firstpara'}) ## 输出同上
</div>
3.根据节点关系
节点关系无非就是兄弟节点,父子节点这样的
代码如下:</div>