

关联规则挖掘(Association rule mining)是数据挖掘中最活跃的研究方法之一,可以用来发现事情之间的联系,最早是为了发现超市交易数据库中不同的商品之间的关系。(啤酒与尿布)
基本概念
1、支持度的定义:support(X-->Y) = |X交Y|/N=集合X与集合Y中的项在一条记录中同时出现的次数/数据记录的个数。例如:support({啤酒}-->{尿布}) = 啤酒和尿布同时出现的次数/数据记录数 = 3/5=60%。
2、自信度的定义:confidence(X-->Y) = |X交Y|/|X| = 集合X与集合Y中的项在一条记录中同时出现的次数/集合X出现的个数 。例如:confidence({啤酒}-->{尿布}) = 啤酒和尿布同时出现的次数/啤酒出现的次数=3/3=100%;confidence({尿布}-->{啤酒}) = 啤酒和尿布同时出现的次数/尿布出现的次数 = 3/4 = 75%
同时满足最小支持度阈值(min_sup)和最小置信度阈值(min_conf)的规则称作强规则 ,如果项集满足最小支持度,则称它为频繁项集
“如何由大型数据库挖掘关联规则?”关联规则的挖掘是一个两步的过程:
1、找出所有频繁项集:根据定义,这些项集出现的频繁性至少和预定义的最小支持计数一样。
2、由频繁项集产生强关联规则:根据定义,这些规则必须满足最小支持度和最小置信度。
Apriori定律
为了减少频繁项集的生成时间,我们应该尽早的消除一些完全不可能是频繁项集的集合,Apriori的两条定律就是干这事的。
Apriori定律1:如果一个集合是频繁项集,则它的所有子集都是频繁项集。举例:假设一个集合{A,B}是频繁项集,即A、B同时出现在一条记录的次数大于等于最小支持度min_support,则它的子集{A},{B}出现次数必定大于等于min_support,即它的子集都是频繁项集。
Apriori定律2:如果一个集合不是频繁项集,则它的所有超集都不是频繁项集。举例:假设集合{A}不是频繁项集,即A出现的次数小于min_support,则它的任何超集如{A,B}出现的次数必定小于min_support,因此其超集必定也不是频繁项集。
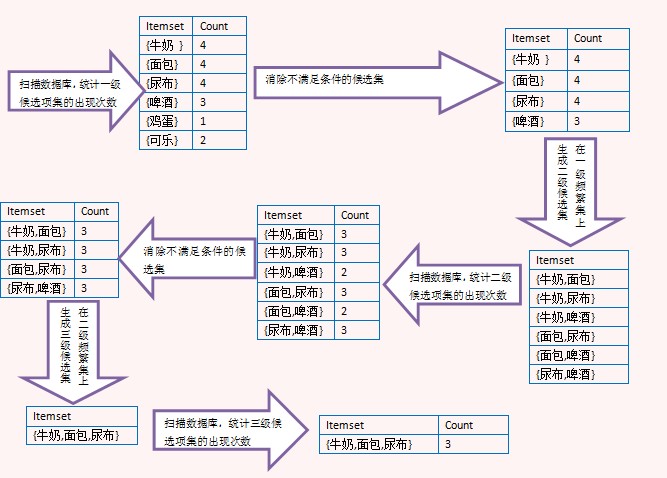
上面的图演示了Apriori算法的过程,注意看由二级频繁项集生成三级候选项集时,没有{牛奶,面包,啤酒},那是因为{面包,啤酒}不是二级频繁项集,这里利用了Apriori定理。最后生成三级频繁项集后,没有更高一级的候选项集,因此整个算法结束,{牛奶,面包,尿布}是最大频繁子集。
Python实现代码:
Skip to content
Sign up Sign in This repository
Explore
Features
Enterprise
Blog
Star 0 Fork 0 taizilongxu/datamining
branch: master datamining / apriori / apriori.py
hackerxutaizilongxu 20 days ago backup
1 contributor
156 lines (140 sloc) 6.302 kb RawBlameHistory
#-*- encoding: UTF-8 -*-
#---------------------------------import------------------------------------
#---------------------------------------------------------------------------
class Apriori(object):
def __init__(self, filename, min_support, item_start, item_end):
self.filename = filename
self.min_support = min_support # 最小支持度
self.min_confidence = 50
self.line_num = 0 # item的行数
self.item_start = item_start # 取哪行的item
self.item_end = item_end
self.location = [[i] for i in range(self.item_end - self.item_start + 1)]
self.support = self.sut(self.location)
self.num = list(sorted(set([j for i in self.location for j in i])))# 记录item
self.pre_support = [] # 保存前一个support,location,num
self.pre_location = []
self.pre_num = []
self.item_name = [] # 项目名
self.find_item_name()
self.loop()
self.confidence_sup()
def deal_line(self, line):
"提取出需要的项"
return [i.strip() for i in line.split(' ') if i][self.item_start - 1:self.item_end]
def find_item_name(self):
"根据第一行抽取item_name"
with open(self.filename, 'r') as F:
for index,line in enumerate(F.readlines()):
if index == 0:
self.item_name = self.deal_line(line)
break
def sut(self, location):
"""
输入[[1,2,3],[2,3,4],[1,3,5]...]
输出每个位置集的support [123,435,234...]
"""
with open(self.filename, 'r') as F:
support = [0] * len(location)
for index,line in enumerate(F.readlines()):
if index == 0: continue
# 提取每信息
item_line = self.deal_line(line)
for index_num,i in enumerate(location):
flag = 0
for j in i:
if item_line[j] != 'T':
flag = 1
break
if not flag:
support[index_num] += 1
self.line_num = index # 一共多少行,出去第一行的item_name
return support
def select(self, c):
"返回位置"
stack = []
&nbs