

接下来准备用糗百做一个爬虫的小例子。
但是在这之前,先详细的整理一下Python中的正则表达式的相关内容。
正则表达式在Python爬虫中的作用就像是老师点名时用的花名册一样,是必不可少的神兵利器。
一、 正则表达式基础
1.1.概念介绍
正则表达式是用于处理字符串的强大工具,它并不是Python的一部分。
其他编程语言中也有正则表达式的概念,区别只在于不同的编程语言实现支持的语法数量不同。
它拥有自己独特的语法以及一个独立的处理引擎,在提供了正则表达式的语言里,正则表达式的语法都是一样的。
下图展示了使用正则表达式进行匹配的流程:
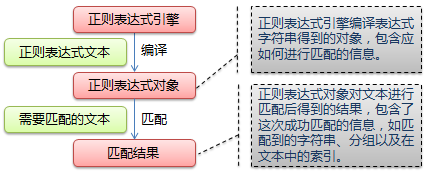
正则表达式的大致匹配过程是:
1.依次拿出表达式和文本中的字符比较,
2.如果每一个字符都能匹配,则匹配成功;一旦有匹配不成功的字符则匹配失败。
3.如果表达式中有量词或边界,这个过程会稍微有一些不同。
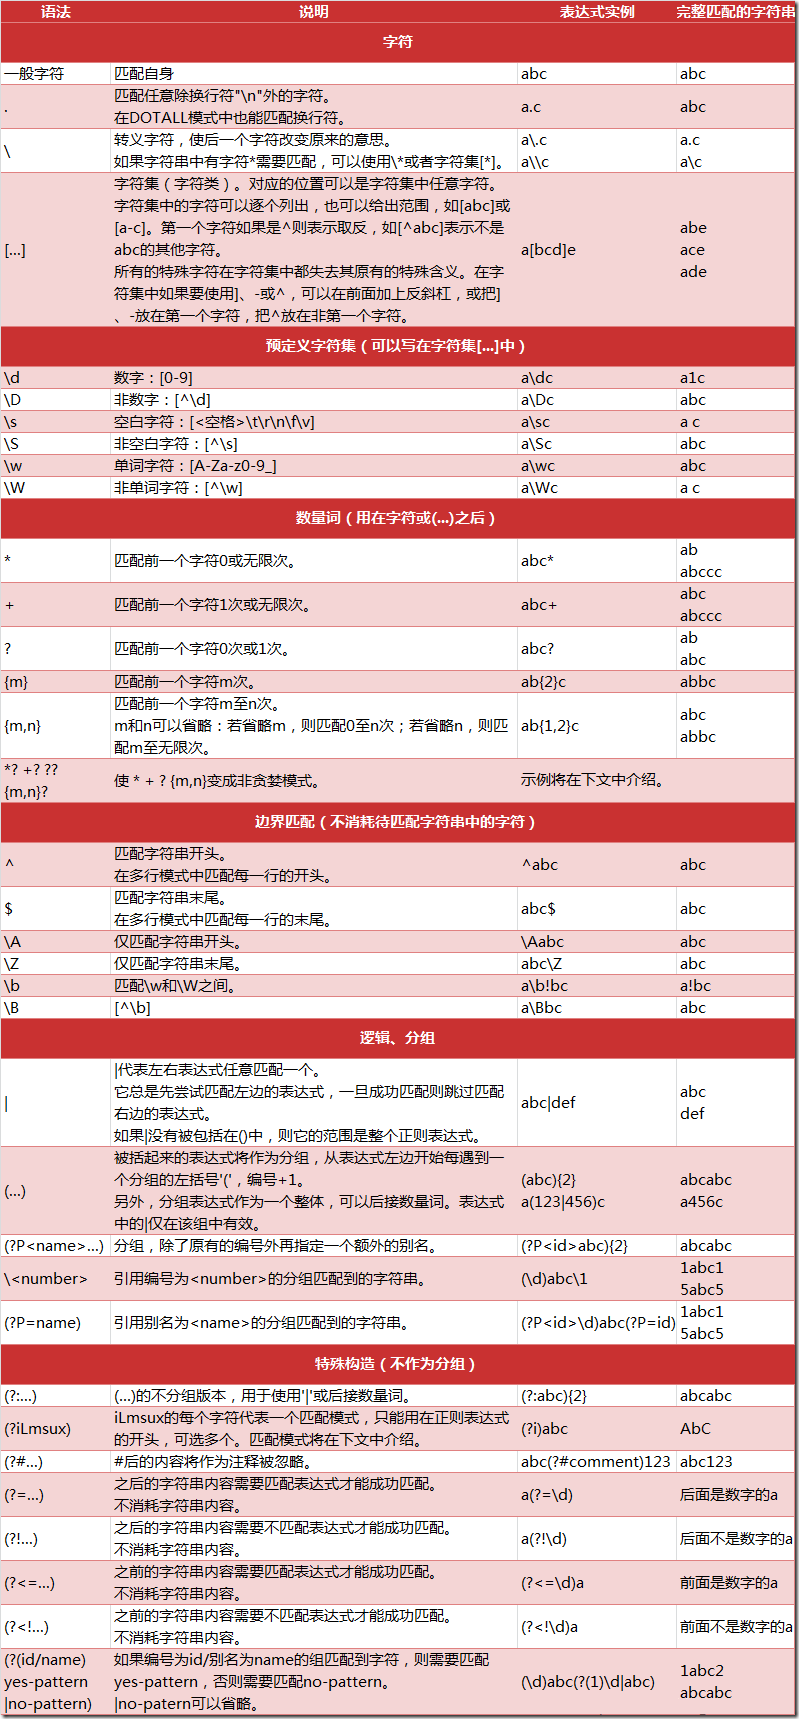
下图列出了Python支持的正则表达式元字符和语法:
1.2. 数量词的贪婪模式与非贪婪模式
正则表达式通常用于在文本中查找匹配的字符串。
贪婪模式,总是尝试匹配尽可能多的字符;
非贪婪模式则相反,总是尝试匹配尽可能少的字符。
Python里数量词默认是贪婪的。
例如:正则表达式"ab*"如果用于查找"abbbc",将找到"abbb"。
而如果使用非贪婪的数量词"ab*?",将找到"a"。
1.3. 反斜杠的问题
与大多数编程语言相同,正则表达式里使用"\"作为转义字符,这就可能造成反斜杠困扰。
假如你需要匹配文本中的字符"\",那么使用编程语言表示的正则表达式里将需要4个反斜杠"\\\\":
第一个和第三个用于在编程语言里将第二个和第四个转义成反斜杠,
转换成两个反斜杠\\后再在正则表达式里转义成一个反斜杠用来匹配反斜杠\。
这样显然是非常麻烦的。
Python里的原生字符串很好地解决了这个问题,这个例子中的正则表达式可以使用r"\\"表示。
同样,匹配一个数字的"\\d"可以写成r"\d"。
有了原生字符串,妈妈再也不用担心我的反斜杠问题~
二、 介绍re模块
2.1. Compile
Python通过re模块提供对正则表达式的支持。
使用re的一般步骤是:
Step1:先将正则表达式的字符串形式编译为Pattern实例。
Step2:然后使用Pattern实例处理文本并获得匹配结果(一个Match实例)。
Step3:最后使用Match实例获得信息,进行其他的操作。
我们新建一个re01.py来试验一下re的应用:
# -*- coding: utf-8 -*-
#一个简单的re实例,匹配字符串中的hello字符串
#导入re模块
import re
# 将正则表达式编译成Pattern对象,注意hello前面的r的意思是“原生字符串”
pattern = re.compile(r'hello')
# 使用Pattern匹配文本,获得匹配结果,无法匹配时将返回None
match1 = pattern.match('hello world!')
match2 = pattern.match('helloo world!')
match3 = pattern.match('helllo world!')
#如果match1匹配成功
if match1:
# 使用Match获得分组信息
print match1.group()
else:
print 'match1匹配失败!'
#如果match2匹配成功
if match2:
# 使用Match获得分组信息
print match2.group()
else:
print 'match2匹配失败!'
#如果match3匹配成功
if match3:
# 使用Match获得分组信息
print match3.group()
else:
print 'match3匹配失败!'
</div>
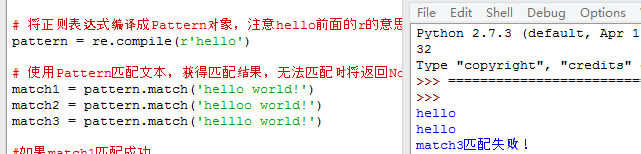
可以看到控制台输出了匹配的三个结果:
下面来具体看看代码中的关键方法。
★ re.compile(strPattern[, flag]):
这个方法是Pattern类的工厂方法,用于将字符串形式的正则表达式编译为Pattern对象。
第二个参数flag是匹配模式,取值可以使用按位或运算符'|'表示同时生效,比如re.I | re.M。
另外,你也可以在regex字符串中指定模式,
比如re.compile('pattern', re.I | re.M)与re.compile('(?im)pattern')是等价的。
可选值有:
re.I(全拼:IGNORECASE): 忽略大小写(括号内是完整写法,下同)
re.M(全拼:MULTILINE): 多行模式,改变'^'和'$'的行为(参见上图)
re.S(全拼:DOTALL): 点任意匹配模式,改变'.'的行为
re.L(全拼:LOCALE): 使预定字符类 \w \W \b \B \s \S 取决于当前区域设定
re.U(全拼:UNICODE): 使预定字符类 \w \W \b \B \s \S \d \D 取决于unicode定义的字符属性
re.X(全拼:VERBOSE): 详细模式。这个模式下正则表达式可以是多行,忽略空白字符,并可以加入注释。
以下两个正则表达式是等价的:
# -*- coding: utf-8 -*-
#两个等价的re匹配,匹配一个小数
import re
a = re.compile(r"""\d + # the integral part
\. # the decimal point
\d * # some fractional digits""", re.X)
b = re.compile(r"\d+\.\d*")
match11 = a.match('3.1415')
match12 = a.match('33')
match21 = b.match('3.1415')
match22 = b.match('33')
if match11:
# 使用Match获得分组信息
print match11.group()
else:
print u'match11不是小数'
if match12:
# 使用Match获得分组信息
print match12.group()
else:
print u'match12不是小数'
if match21:
# 使用Match获得分组信息
print match21.group()
else:
print u'match21不是小数'
if match22:
# 使用Match获得分组信息
print match22.group()
else:
print u'match22不是小数'
</div>
re提供了众多模块方法用于完成正则表达式的功能。
这些方法可以使用Pattern实例的相应方法替代,唯一的好处是少写一行re.compile()代码,
但同时也无法复用编译后的Pattern对象。
这些方法将在Pattern类的实例方法部分一起介绍。
如一开始的hello实例可以简写为:
# -*- coding: utf-8 -*-
#一个简单的re实例,匹配字符串中的hello字符串
import re
m = re.match(r'hello', 'hello world!')
print m.group()
</div>
re模块还提供了一个方法escape(string),用于将string中的正则表达式元字符如*/+/?等之前加上转义符再返回
2.2. Match
Match对象是一次匹配的结果,包含了很多关于此次匹配的信息,可以使用Match提供的可读属性或方法来获取这些信息。
属性:
string: 匹配时使用的文本。
re: 匹配时使用的Pattern对象。
pos: 文本中正则表达式开始搜索的索引。值与Pattern.match()和Pattern.seach()方法的同名参数相同。
endpos: 文本中