

通过本文主要向大家介绍了汉字转gbk编码,汉字转gbk,汉字转gbk编码软件,gbk汉字,在线汉字注音gbk版等相关知识,希望对您有所帮助,也希望大家支持linkedu.com www.linkedu.com
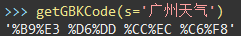
如图,“广”的编码为%B9%E3,暂且把%B9称为节编码,%E3为字符编码(第二编码)。
思路:
从GBK编码页面收集汉字 http://ff.163.com/newflyff/gbk-list/
从实用角度下手,只选取“● GBK/2: GB2312 汉字”这一节,共3755个汉字。
看规律:小节编码从B0-D7,而针对汉字的编码从A1-FE,即16*6-2=94,非常有规律性。
第一步:把常用的汉字用python提取出来,按顺序存到一个字典文件里面,汉字用空格分隔。
第二步:根据编码从A1-FE,每节94个汉字的规律,先定位节编码,利用汉字在某一节的位置定位字符编码
实施:
第一步:提取汉字


删除掉这些字符:
先把分割得到的list全部解码,然后
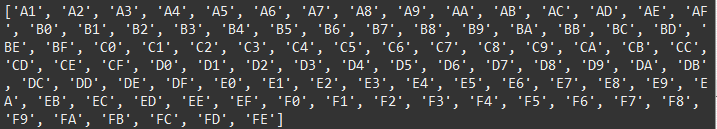
有了这个编码序列后,就可以从gbk库中删除B0-D7字符了。
最后检查到还有空格未删除,空格的unicode码是\u3000
gbk.remove(u'\u3000')
最后encode成UTF-8编码保存到字典文件。
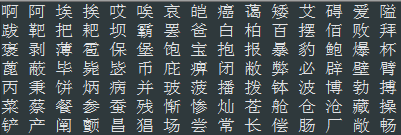
我把这个字典文件放到网盘上了,外链:http://dl.dbank.com/c0m9selr6h
第二步:索引汉字
索引就是个简单算法,因为字典里面的汉子是按照原先顺序存储的,而且GBK编码表2的3755个汉字严格遵守每节94个汉字的规律,那就来个简单的除数取整+1来定位小节编码,再用汉字索引-节索引*94得到汉字在这一小节中的索引,然后利用上面生成的A1-FE list和索引来定位第二编码。
算法思路有了,编码,然后调试
附上python代码和注释:
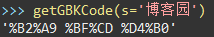
得承认我的python代码不是那么工整
附上我的微博ID:小栾Cooper