

虚拟机下Linux系统Hadoop单机/伪分布式配置:Hadoop2.5.2+Ubuntu14.04(半原创),hadoophadoop2.5.2
- 系统: Ubuntu 14.04 64bit
- Hadoop版本: Hadoop 2.5.2 (stable)
- JDK版本: JDK 1.6
虚拟机及Ubuntu安装
1. 下载并安装 VMware workstation 11
下载地址:https://my.vmware.com/web/vmware/info/slug/desktop_end_user_computing/vmware_workstation/11_0?wd=%20VMware%20workstation%2011%20&issp=1&f=3&ie=utf-8&tn=baiduhome_pg&inputT=1321&rsp=1
2. 下载Ubuntu 14.04,注意在虚拟机上安装之前需要解压!
3.在Vmware中新建虚拟机:虚拟机安装向导,标准,安装盘镜像文件:指向ubuntu 14.04解压的wubi.exe的路径。
4.虚拟机命名,注意保存路径,默认分配磁盘空间20G,虚拟磁盘拆分成多个文件。
虚拟机安装完成后自动启动安装
创建hadoop用户
如果你安装Ubuntu的时候不是用的hadoop用户,那么需要增加一个名为hadoop的用户,并将密码设置为hadoop。
创建用户
sudo useradd hadoop
修改密码为hadoop,按提示输入两次密码
sudo passwd hadoop
给hadoop用户创建目录,方可登陆
sudo mkdir /home/hadoop
sudo chown hadoop /home/hadoop
可考虑为 hadoop 用户增加管理员权限,方便部署,避免一些权限不足的问题:
sudo adduser hadoop sudo
最后注销当前用户,使用hadoop用户进行登陆。
1.通过火狐浏览器下载jdk-6u45-linux-x64.bin(以下操作在虚拟机中进行) sudo cp/home/moweiyang01/Downloads/jdk-6u45-linux-x64.bin /home/hadoop/ sudo chomd u+x jdk-6u45-linux-x64.bin 运行jdk,在/home/hadoop$下:./ jdk-6u45-linux-x64.bin mv jdk1.6.0_45 jdk 1.6 sudo gedit /etc/profile
加入以下java的配置信息 export JAVA_HOME=/home/hadoop/jdk1.6 export JRE_HOME=/home/hadoop/jdk1.6/jre export CLASSPATH=.:$JAVA_HOME/lib:$JRE_HOME/lib:$CLASSPATH export PATH=$JAVA_HOME/bin:$JRE_HOME/bin:$PATH
保存profile文件 在hadoop下运行 source /etc/profile
输入java -version检查java是否配置成功。
在 /etc/environment 中配置:
sudo vim /etc/environmentSSH的配置
输入命令: sudo apt-get install ssh
ssh localhost
然后按提示输入密码hadoop,这样就登陆到本机了。但这样的登陆是需要密码的,需要配置成无密码登陆。
先退出刚才的ssh,然后生成ssh证书:
exit                           # 退出 ssh localhost
cd ~/.ssh                      # 如果没有该目录,先执行一次ssh localhost
ssh-keygen -t rsa              # 一直按回车就可以
cp id_rsa.pub authorized_keys
安装Hadoop 2.5.2
下载后,解压到/usr/local/中。
sudo tar -zxvf ~/Downloads/hadoop-2.5.2.tar.gz -C /usr/local   # 解压到/usr/local中
sudo mv /usr/local/hadoop-2.5.2/ /usr/local/hadoop      # 将文件名改为hadoop
sudo chown -R hadoop:hadoop /usr/local/hadoop       # 修改文件权限
Hadoop解压后即可使用。输入如下命令Hadoop检查是否可用,成功则会显示命令行的用法:
/usr/local/hadoop/bin/hadoopHadoop单机配置
Hadoop默认配置是以非分布式模式运行,即单Java进程,方便进行调试。可以执行附带的例子WordCount来感受下Hadoop的运行。例子将Hadoop的配置文件作为输入文件,统计符合正则表达式dfs[a-z.]+的单词的出现次数。
cd /usr/local/hadoop
mkdir input
cp etc/hadoop/*.xml input
bin/hadoop jar share/hadoop/mapreduce/hadoop-mapreduce-examples-2.4.1.jar grep input output 'dfs[a-z.]+'
cat ./output/*
执行成功后如下所示,输出了作业的相关信息,输出的结果是符合正则的单词dfsadmin出现了1次
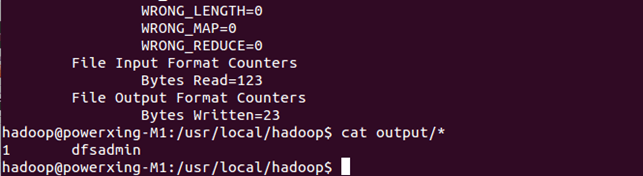 Hadoop单机WordCount输出结果
再次运行会提示出错,需要将./output删除。
rm -R ./output
Hadoop伪分布式配置
Hadoop可以在单节点上以伪分布式的方式运行,Hadoop进程以分离的Java进程来运行,节点即是NameNode也是DataNode。需要修改2个配置文件etc/hadoop/core-site.xml和etc/hadoop/hdfs-site.xml。Hadoop的配置文件是xml格式,声明property的name和value。
修改配置文件etc/hadoop/core-site.xml,将
<configuration>
</configuration>
修改为下面配置:
<configuration>
    <property>
        <name>hadoop.tmp.dir</name>
        <value>file:/usr/local/hadoop/tmp</value>
        <description>Abase for other temporary directories.</description>
    </property>
    <property>
        <name>fs.defaultFS</name>
        <value>hdfs://localhost:9000</value>
    </property>
</configuration>
修改配置文件etc/hadoop/hdfs-site.xml为
<configuration>
    <property>
        <name>dfs.replication</name>
        <value>1</value>
    </property>
    <property>
        <name>dfs.namenode.name.dir</name>
        <value>file:/usr/local/hadoop/tmp/dfs/name</value>
    </property>
    <property>
        <name>dfs.datanode.data.dir</name>
        <value>file:/usr/local/hadoop/tmp/dfs/data</value>
    </property>
</configuration>
关于配置的一点说明:上面只要配置 fs.defaultFS 和 dfs.replication 就可以运行,不过有个说法是如没有配置 hadoop.tmp.dir 参数,此时 Hadoop 默认的使用的临时目录为 /tmp/hadoo-hadoop,而这个目录在每次重启后都会被干掉,必须重新执行 format 才行(未验证),所以伪分布式配置中最好还是设置一下。此外也需要显式指定 dfs.namenode.name.dir 和 dfs.datanode.data.dir,否则下一步可能会出错。
配置完成后,首先初始化文件系统 HDFS:
bin/hdfs namenode -format
成功的话,最后的提示如下,Exitting with status 0 表示成功,Exitting
with status 1: 则是出错。若出错,可试着加上 sudo, 既 sudo bin/hdfs namenode -format 试试看。
 初始化HDFS文件系统
接着开启NaneNode