

通过本文主要向大家介绍了python pandas,python pandas教程,python pandas安装,python pandas 下载,python中pandas等相关知识,希望对您有所帮助,也希望大家支持linkedu.com www.linkedu.com
起步
Pandas最初被作为金融数据分析工具而开发出来,因此 pandas 为时间序列分析提供了很好的支持。 Pandas 的名称来自于面板数据(panel data)和python数据分析 (data analysis) 。panel data是经济学中关于多维数据集的一个术语,在Pandas中也提供了panel的数据类型。
在我看来,对于 Numpy 以及 Matplotlib ,Pandas可以帮助创建一个非常牢固的用于数据挖掘与分析的基础。而Scipy当然是另一个主要的也十分出色的科学计算库。
安装与导入
通过pip进行安装: pip install pandas
导入:
import pandas as pd</div>
Pandas的数据类型
Pandas基于两种数据类型: series 与 dataframe 。
Series
一个series是一个一维的数据类型,其中每一个元素都有一个标签。类似于Numpy中元素带标签的数组。其中,标签可以是数字或者字符串。
# coding: utf-8
import numpy as np
import pandas as pd

s = pd.Series([1, 2, 5, np.nan, 6, 8])
print s
</div>
输出:
0 1.0
1 2.0
2 5.0
3 NaN
4 6.0
5 8.0
dtype: float64
</div>
DataFrame
一个dataframe是一个二维的表结构。Pandas的dataframe可以存储许多种不同的数据类型,并且每一个坐标轴都有自己的标签。你可以把它想象成一个series的字典项。
创建一个 DateFrame:
#创建日期索引序列
dates = pd.date_range('20130101', periods=6)
#创建Dataframe,其中 index 决定索引序列,columns 决定列名
df = pd.DataFrame(np.random.randn(6,4), index=dates, columns=list('ABCD'))
print df
</div>
输出:
   A  B  C  D
2013-01-01 -0.334482 0.746019 -2.205026 -0.803878
2013-01-02 2.007879 1.559073 -0.527997 0.950946
2013-01-03 -1.053796 0.438214 -0.027664 0.018537
2013-01-04 -0.208744 -0.725155 -0.395226 -0.268529
2013-01-05 0.080822 -1.215433 -0.785030 0.977654
2013-01-06 -0.126459 0.426328 -0.474553 -1.968056
</div>
字典创建 DataFrame
df2 = pd.DataFrame({ 'A' : 1.,
   'B' : pd.Timestamp('20130102'),
   'C' : pd.Series(1,index=list(range(4)),dtype='float32'),
   'D' : np.array([3] * 4,dtype='int32'),
   'E' : pd.Categorical(["test","train","test","train"]),
   'F' : 'foo' })
</div>
输出:
 A  B C D E F
0 1 2013-01-02 1 3 test foo
1 1 2013-01-02 1 3 train foo
2 1 2013-01-02 1 3 test foo
3 1 2013-01-02 1 3 train foo
</div>
将文件数据导入Pandas
df = pd.read_csv("Average_Daily_Traffic_Counts.csv", header = 0)
df.head()
</div>
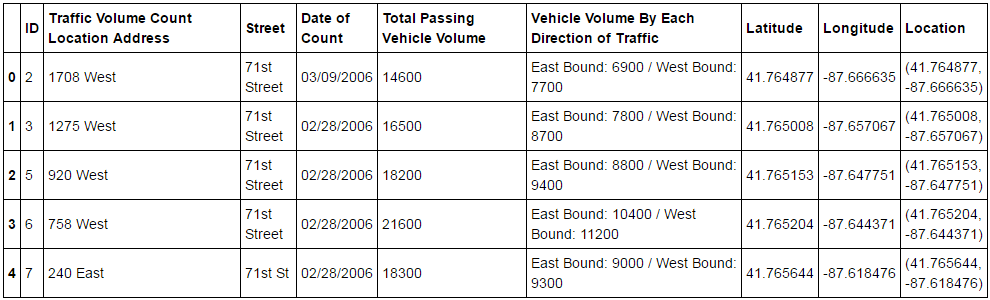
数据源可以是 英国政府数据 或 美国政府数据 来获取数据源。当然, Kaggle 是另一个好用的数据源。
选择/切片
# 选择单独的一列,返回 Serires,与 df.A 效果相当。
df['A']

# 位置切片
df[0:3]

# 索引切片
df['20130102':'20130104']

# 通过标签选择
df.loc[dates[0]]

# 对多个轴同时通过标签进行选择
df.loc[:,['A','B']]

# 获得某一个单元的数据
df.loc[dates[0],'A']
# 或者
df.at[dates[0],'A'] # 速度更快的做法

# 通过位置进行选择
df.iloc[3]

# 切片
df.iloc[3:5,0:2]

# 列表选择
df.iloc[[1,2,4],[0,2]]

# 获得某一个单元的数据
df.iloc[1,1]
# 或者
df.iat[1,1] # 更快的做法

# 布尔索引
df[df.A > 0]

# 获得大于零的项的数值
df[df > 0]

# isin 过滤
df2[df2['E'].isin(['two','four'])]
</div>
赋值
# 新增一列,根据索引排列
s1 = pd.Series([1,2,3,4,5,6], index=pd.date_range('20130102', periods=6))
df['F'] = s1

# 缺省项
# 在 pandas 中使用 np.nan 作为缺省项的值。
df1 = df.reindex(index=dates[0:4], columns=list(df.columns) + ['E'])
df1.loc[dates[0]:dates[1],'E'] = 1

# 删除所有带有缺省项的行
df1.dropna(how='any')

# 填充缺省项
df1.fillna(value=5)

# 获得缺省项的布尔掩码
pd.isnull(df1)
</div>
观察操作
# 观察开头的数据
df.head()

# 观察末尾的数据
df.tail(3)

# 显示索引
df.index

# 显示列
df.columns

# 显示底层 numpy 结构
df.values

# DataFrame 的基本统计学属性预览
df.describe()
"""
  A  B  C  D
count 6.000000 6.000000 6.000000 6.000000 #数量
mean 0.073711 -0.431125 -0.687758 -0.233103 #平均值
std 0.843157 0.922818 0.779887 0.973118 #标准差
min -0.861849 -2.104569 -1.509059 -1.135632 #最小值
25% -0.611510 -0.600794 -1.368714 -1.076610 #正态分布 25%
50% 0.022070 -0.228039 -0.767252 -0.386188 #正态分布 50%
75% 0.658444 0.041933 -0.034326 0.461706 #正态分布 75%
max 1.212112 0.567020 0.276232 1.071804 #最大值
"""

# 转置
df.T

# 根据某一轴的索引进行排序
df.sort_index(axis=1, ascending=False)

# 根据某一列的数值进行排序
df.sort(columns='B')
</div>
统计
# 求平均值
df.mean()
"""
A -0.004474
B -0.383981
C -0.687758
D 5.000000
F 3.000000
dtype: float64
"""

# 指定轴上的平均值
df.mean(1)

# 不同维度的 pandas 对象也可以做运算,它会自动进行对应,shift 用来做对齐操作。
s = pd.Series([1,3,5,np.nan,6,8], index=dates).shift(2)
"""
2013-01-01 NaN
2013-01-02 NaN
2013-01-03 1
2013-01-04 3
2013-01-05 5
2013-01-06 NaN
Freq: D, dtype: float64
"""

# 对不同维度的 pandas 对象进行减法操作
df.sub(s, axis='index')
"""
   A  B  C D F
2013-01-01 NaN NaN NaN NaN NaN
2013-01-02 NaN NaN NaN NaN NaN
2013-01-03 -1.861849 -3.104569 -1.494929 4 1
2013-01-04 -2.278445 -3.706771 -4.039575 2 0
2013-01-05 -5.424972 -4.432980 -4.723768 0 -1
2013-01-06 NaN NaN NaN NaN NaN
"""
</div>
函数应用
# 累加
df.apply(np.cumsum)
</div>
直方图
s = pd.Series(np.random.randint(0, 7, size=10))
s.value_counts()
"""
4 5
6 2
2 2
1 1
dtype: int64
String Methods
"""
</div>
字符处理
s = pd.Series(['A', 'B', 'C', 'Aaba', 'Baca', np.nan, 'CABA', 'dog', 'cat'])
s.str.lower()
"""
0 a
1 b
2 c
3 aaba
4 baca
5 NaN
6 caba
7 dog
8 cat
dtype: object
"""
</div>
合并
使用 concat() 连接 pandas 对象:
df = pd.DataFrame(np.random.randn(10, 4))
"""
  0  1  2  3
0 -0.548702 1.467327 -1.015962 -0.483075
1 1.637550 -1.217659 -0.291519 -1.745505
2 -0.263952 0.991460 -0.919069 0.266046
3 -0.709661 1.669052 1.037882 -1.705775
4 -0.919854 -0.042379 1.247642 -0.009920
5 0.290213 0.495767 0.362949 1.548106
6 -1.131345 -0.089329 0.337863 -0.945867
7 -0.932132 1.956030 0.017587 -0.016692
8 -0.575247 0.254161 -1.143704 0.215897
9 1.193555 -0.077118 -0.408530 -0.862495
"""

pieces = [df[:3], df[3:7], df[7:]]
pd.concat(pieces)
"""
  0  1  2  3
0 -0.548702 1.467327 -1.015962 -0.483075
1 1.637550 -1.217659 -0.291519 -1.745505
2 -0.263952 0.991460 -0.919069 0.266046
3 -0.709661 1.669052 1.037882 -1.705775
4 -0.919854 -0.042379 1.247642 -0.009920
5 0.290213 0.495767 0.362949 1.548106
6 -1.131345 -0.089329 0.337863 -0.945867
7 -0.932132 1.956030 0.017587 -0.016692
8 -0.575247 0.254161 -1.143704 0.215897
9 1.193555 -0.077118 -0.408530 -0.862495
"""
</div>
join 合并: