

一、排序的基本概念和分类
所谓排序,就是使一串记录,按照其中的某个或某些关键字的大小,递增或递减的排列起来的操作。排序算法,就是如何使得记录按照要求排列的方法。
排序的稳定性:
经过某种排序后,如果两个记录序号同等,且两者在原无序记录中的先后秩序依然保持不变,则称所使用的排序方法是稳定的,反之是不稳定的。
内排序和外排序
内排序:排序过程中,待排序的所有记录全部放在内存中
外排序:排序过程中,使用到了外部存储。
通常讨论的都是内排序。
影响内排序算法性能的三个因素:
- 时间复杂度:即时间性能,高效率的排序算法应该是具有尽可能少的关键字比较次数和记录的移动次数
- 空间复杂度:主要是执行算法所需要的辅助空间,越少越好。
- 算法复杂性。主要是指代码的复杂性。
根据排序过程中借助的主要操作,可把内排序分为:
- 插入排序
- 交换排序
- 选择排序
- 归并排序
按照算法复杂度可分为两类:
- 简单算法:包括冒泡排序、简单选择排序和直接插入排序
- 改进算法:包括希尔排序、堆排序、归并排序和快速排序
以下的七种排序算法只是所有排序算法中最经典的几种,不代表全部。
二、 冒泡排序
冒泡排序(Bubble sort):时间复杂度O(n^2)
交换排序的一种。其核心思想是:两两比较相邻记录的关键字,如果反序则交换,直到没有反序记录为止。
其实现细节可以不同,比如下面3种:
1.最简单排序实现:bubble_sort_simple
2.冒泡排序:bubble_sort
3.改进的冒泡排序:bubble_sort_advance
#!/usr/bin/env python
# -*- coding:utf-8 -*-
# Author: Liu Jiang
# Python 3.5
# 冒泡排序算法

class SQList:
  def __init__(self, lis=None):
    self.r = lis

  def swap(self, i, j):
    """定义一个交换元素的方法,方便后面调用。"""
    temp = self.r[i]
    self.r[i] = self.r[j]
    self.r[j] = temp

  def bubble_sort_simple(self):
    """
    最简单的交换排序,时间复杂度O(n^2)
    """
    lis = self.r
    length = len(self.r)
    for i in range(length):
      for j in range(i+1, length):
        if lis[i] > lis[j]:
          self.swap(i, j)

  def bubble_sort(self):
    """
    冒泡排序,时间复杂度O(n^2)
    """
    lis = self.r
    length = len(self.r)
    for i in range(length):
      j = length-2
      while j >= i:
        if lis[j] > lis[j+1]:
          self.swap(j, j+1)
        j -= 1

  def bubble_sort_advance(self):
    """
    冒泡排序改进算法,时间复杂度O(n^2)
    设置flag,当一轮比较中未发生交换动作,则说明后面的元素其实已经有序排列了。
    对于比较规整的元素集合,可提高一定的排序效率。
    """
    lis = self.r
    length = len(self.r)
    flag = True
    i = 0
    while i < length and flag:
      flag = False
      j = length - 2
      while j >= i:
        if lis[j] > lis[j + 1]:
          self.swap(j, j + 1)
          flag = True
        j -= 1
      i += 1

  def __str__(self):
    ret = ""
    for i in self.r:
      ret += " %s" % i
    return ret

if __name__ == '__main__':
  sqlist = SQList([4,1,7,3,8,5,9,2,6])
  # sqlist.bubble_sort_simple()
  # sqlist.bubble_sort()
  sqlist.bubble_sort_advance()
  print(sqlist)
</div>
三、简单选择排序
简单选择排序(simple selection sort):时间复杂度O(n^2)
通过n-i次关键字之间的比较,从n-i+1个记录中选出关键字最小的记录,并和第i(1<=i<=n)个记录进行交换。
通俗的说就是,对尚未完成排序的所有元素,从头到尾比一遍,记录下最小的那个元素的下标,也就是该元素的位置。再把该元素交换到当前遍历的最前面。其效率之处在于,每一轮中比较了很多次,但只交换一次。因此虽然它的时间复杂度也是O(n^2),但比冒泡算法还是要好一点。
#!/usr/bin/env python
# -*- coding:utf-8 -*-
# Author: Liu Jiang
# Python 3.5
# 简单选择排序


class SQList:
  def __init__(self, lis=None):
    self.r = lis

  def swap(self, i, j):
    """定义一个交换元素的方法,方便后面调用。"""
    temp = self.r[i]
    self.r[i] = self.r[j]
    self.r[j] = temp

  def select_sort(self):
    """
    简单选择排序,时间复杂度O(n^2)
    """
    lis = self.r
    length = len(self.r)
    for i in range(length):
      minimum = i
      for j in range(i+1, length):
        if lis[minimum] > lis[j]:
          minimum = j
      if i != minimum:
        self.swap(i, minimum)

  def __str__(self):
    ret = ""
    for i in self.r:
      ret += " %s" % i
    return ret

if __name__ == '__main__':
  sqlist = SQList([4, 1, 7, 3, 8, 5, 9, 2, 6, 0])
  sqlist.select_sort()
  print(sqlist)
</div>
四、直接插入排序
直接插入排序(Straight Insertion Sort):时间复杂度O(n^2)
基本操作是将一个记录插入到已经排好序的有序表中,从而得到一个新的、记录数增1的有序表。
#!/usr/bin/env python
# -*- coding:utf-8 -*-
# Author: Liu Jiang
# Python 3.5
# 直接插入排序


class SQList:
  def __init__(self, lis=None):
    self.r = lis

  def insert_sort(self):
    lis = self.r
    length = len(self.r)
    # 下标从1开始
    for i in range(1, length):
      if lis[i] < lis[i-1]:
        temp = lis[i]
        j = i-1
        while lis[j] > temp and j >= 0:
          lis[j+1] = lis[j]
          j -= 1
        lis[j+1] = temp

  def __str__(self):
    ret = ""
    for i in self.r:
      ret += " %s" % i
    return ret

if __name__ == '__main__':
  sqlist = SQList([4, 1, 7, 3, 8, 5, 9, 2, 6, 0])
  sqlist.insert_sort()
  print(sqlist)
</div>
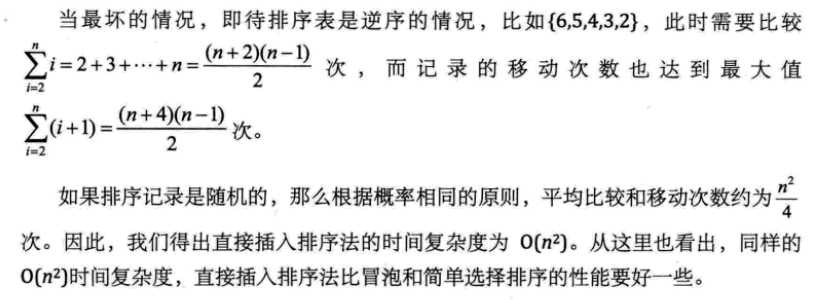
该算法需要一个记录的辅助空间。最好情况下,当原始数据就是有序的时候,只需要一轮对比,不需要移动记录,此时时间复杂度为O(n)。然而,这基本是幻想。
五、希尔排序
希尔排序(Shell Sort)是插入排序的改进版本,其核心思想是将原数据集合分割成若干个子序列,然后再对子序列分别进行直接插入排序,使子序列基本有序,最后再对全体记录进行一次直接插入排序。
这里最关键的是跳跃和分割的策略,也就是我们要怎么分割数据,间隔多大的问题。通常将相距某个“增量”的记录组成一个子序列,这样才能保证在子序列内分别进行直接插入排序后得到的结果是基本有序而不是局部有序。下面的例子中通过:increment = int(increment/3)+1来确定“增量”的值。
希尔排序的时间复杂度为:O(n^(3/2))
#!/usr/bin/env python
# -*- coding:utf-8 -*-
# Author: Liu Jiang
# Python 3.5
# 希尔排序


class SQList:
  def __init__(self, lis=None):
    self.r = lis

  def shell_sort(self):
    """希尔排序"""
    lis = self.r
    length = len(lis)
    increment = len(lis)
    while increment > 1:
      increment = int(increment/3)+1
      for i in range(increment+1, length):
        if lis[i] < lis[i - increment]:
          temp = lis[i]
          j = i - increment
          while j >= 0 and temp < lis[j]:
            lis[j+increment] = lis[j]
            j -= increment
          lis[j+increment] = temp

  def __str__(self):
    ret = ""
    for i in self.r:
      ret += " %s" % i
    return ret

if __name__ == '__main__':
  sqlist = SQList([4, 1, 7, 3, 8, 5, 9, 2, 6, 0,123,22])
  sqlist.shell_sort()
  print(sqlist)
</div>
六、堆排序
堆是具有下列性质的完全二叉树:
每个分支节点的值都大于或等于其左右孩子的值,称为大顶堆;
每个分支节点的值都小于或等于其做右孩子的值,称为小顶堆;
因此,其根节点一定是所有节点中最大(最小)的值。
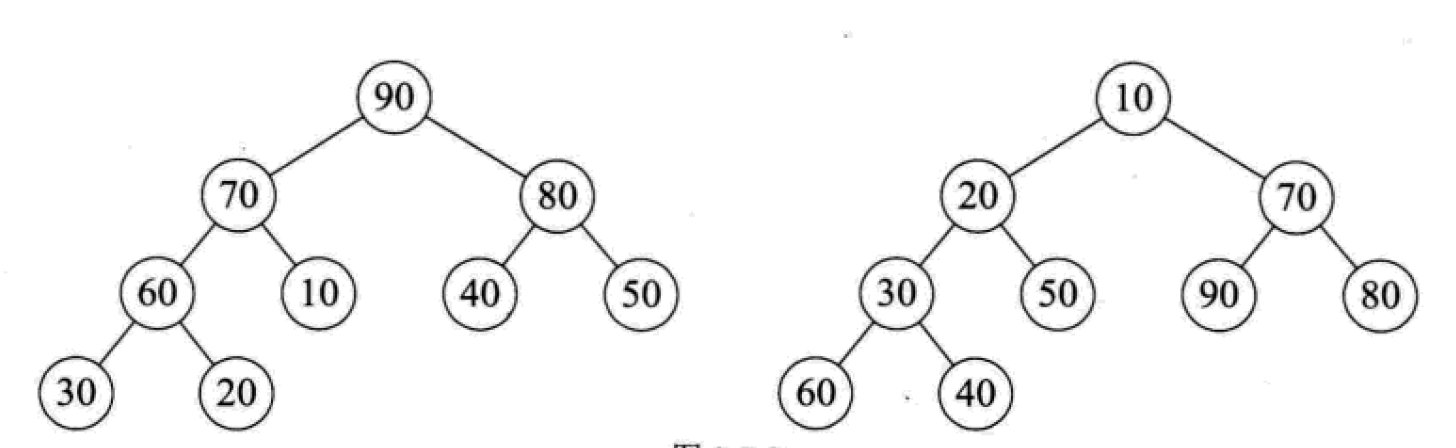
如果按照层序遍历的方式(广度优先)给节点从1开始编号,