

通过本文主要向大家介绍了python爬取淘宝评论,python爬取淘宝数据,python爬取淘宝,python 淘宝,python爬虫淘宝等相关知识,希望对您有所帮助,也希望大家支持linkedu.com www.linkedu.com
支付宝十年账单上的数字有点吓人,但它统计的项目太多,只是想看看到底单纯在淘宝上支出了多少,于是写了段脚本,统计任意时间段淘宝订单的消费情况,看那结果其实在淘宝上我还是相当节约的说。
脚本的主要工作是模拟了浏览器登录,解析“已买到的宝贝”页面以获得指定的订单及宝贝信息。
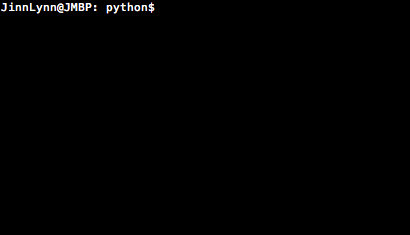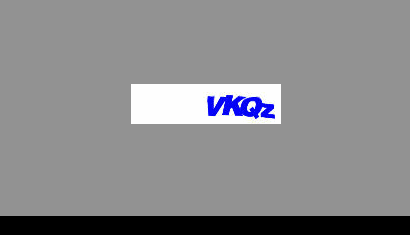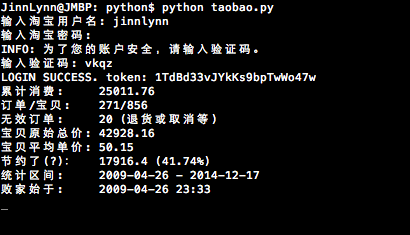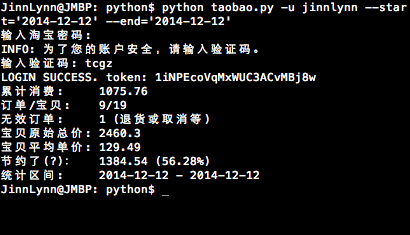
使用方法见代码或执行命令加参数-h,另外需要BeautifulSoup4支持,BeautifulSoup的官方项目列表页:https://www.crummy.com/software/BeautifulSoup/bs4/download/
首先来说一下代码使用方法:
python taobao.py -u USERNAME -p PASSWORD -s START-DATE -e END-DATE --verbose</div>
所有参数均可选,如:
python taobao.py -u jinnlynn</div>
统计用户jinnlynn所有订单的情况
python taobao.py -s 2014-12-12 -e 2014-12-12</div>
统计用户(用户名在命令执行时会要求输入)在2014-12-12当天的订单情况
python taobao.py --verbose</div>
这样就可以统计并输出订单明细。
好了,说了这么多我们就来看代码吧:
from __future__ import unicode_literals, print_function, absolute_import, division
import urllib
import urllib2
import urlparse
import cookielib
import re
import sys
import os
import json
import subprocess
import argparse
import platform
from getpass import getpass
from datetime import datetime
from pprint import pprint
try:
from bs4 import BeautifulSoup
except ImportError:
sys.exit('BeautifulSoup4 missing.')
__version__ = '1.0.0'
__author__ = 'JinnLynn'
__copyright__ = 'Copyright (c) 2014 JinnLynn'
__license__ = 'The MIT License'
HEADERS = {
'x-requestted-with' : 'XMLHttpRequest',
'Accept-Language' : 'zh-cn',
'Accept-Encoding' : 'gzip, deflate',
'ContentType' : 'application/x-www-form-urlencoded; chartset=UTF-8',
'Cache-Control' : 'no-cache',
'User-Agent' :'Mozilla/5.0 (Macintosh; Intel Mac OS X 10_9_5) AppleWebKit/537.36 (KHTML, like Gecko) Chrome/40.0.2214.38 Safari/537.36',
'Connection' : 'Keep-Alive'
}
DEFAULT_POST_DATA = {
'TPL_username' : '', #用户名
'TPL_password' : '', #密码
'TPL_checkcode' : '',
'need_check_code' : 'false',
'callback' : '0', # 有值返回JSON
}
# 无效订单状态
INVALID_ORDER_STATES = [
'CREATE_CLOSED_OF_TAOBAO', # 取消
'TRADE_CLOSED', # 订单关闭
]
LOGIN_URL = 'https://login.taobao.com/member/login.jhtml'
RAW_IMPUT_ENCODING = 'gbk' if platform.system() == 'Windows' else 'utf-8'
def _request(url, data, method='POST'):
if data:
data = urllib.urlencode(data)
if method == 'GET':
if data:
url = '{}?{}'.format(url, data)
data = None
# print(url)
# print(data)
req = urllib2.Request(url, data, HEADERS)
return urllib2.urlopen(req)
def stdout_cr(msg=''):
sys.stdout.write('\r{:10}'.format(' '))
sys.stdout.write('\r{}'.format(msg))
sys.stdout.flush()
def get(url, data=None):
return _request(url, data, method='GET')
def post(url, data=None):
return _request(url, data, method='POST')
def login_post(data):
login_data = DEFAULT_POST_DATA
login_data.update(data)
res = post(LOGIN_URL, login_data)
return json.load(res, encoding='gbk')
def login(usr, pwd):
data = {
'TPL_username' : usr.encode('utf-8' if platform.system() == 'Windows' else 'GB18030'),
'TPL_password' : pwd
}
# 1. 尝试登录
ret = login_post(data)
while not ret.get('state', False):
code = ret.get('data', {}).get('code', 0)
if code == 3425 or code == 1000:
print('INFO: {}'.format(ret.get('message')))
check_code = checkcode(ret.get('data', {}).get('ccurl'))
data.update({'TPL_checkcode' : check_code, 'need_check_code' : 'true'})
ret = login_post(data)
else:
sys.exit('ERROR. code: {}, message:{}'.format(code, ret.get('message', '')))
token = ret.get('data', {}).get('token')
print('LOGIN SUCCESS. token: {}'.format(token))
# 2. 重定向
# 2.1 st值
res = get('https://passport.alipay.com/mini_apply_st.js', {
'site' : '0',
'token' : token,
'callback' : 'stCallback4'})
content = res.read()
st = re.search(r'"st":"(\S*)"( |})', content).group(1)
# 2.1 重定向
get('http://login.taobao.com/member/vst.htm',
{'st' : st, 'TPL_uesrname' : usr.encode('GB18030')})
def checkcode(url):
filename, _ = urllib.urlretrieve(url)
if not filename.endswith('.jpg'):
old_fn = filename
filename = '{}.jpg'.format(filename)
os.rename(old_fn, filename)
if platform.system() == 'Darwin':
# mac 下直接preview打开
subprocess.call(['open', filename])
elif platform.system() == 'Windows':
# windows 执行文件用默认程序打开
subprocess.call(filename, shell=True)
else:
# 其它系统 输出文件名
print('打开该文件获取验证码: {}'.format(filename))
return raw_input('输入验证码: '.encode(RAW_IMPUT_ENCODING))
def parse_bought_list(start_date=None, end_date=None):
url = 'http://buyer.trade.taobao.com/trade/itemlist/list_bought_items.htm'
# 运费险 增值服务 分段支付(定金,尾款)
extra_service = ['freight-info', 'service-info', 'stage-item']
stdout_cr('working... {:.0%}'.format(0))
# 1. 解析第一页
res = urllib2.urlopen(url)
soup = BeautifulSoup(res.read().decode('gbk'))
# 2. 获取页数相关
page_jump = soup.find('span', id='J_JumpTo')
jump_url = page_jump.attrs['data-url']
url_parts = urlparse.urlparse(jump_url)
query_data = dict(urlparse.parse_qsl(url_parts.query))
total_pages = int(query_data['tPage'])
# 解析
orders = []
cur_page = 1
out_date = False
errors = []
while True:
bought_items = soup.find_all('tbody', attrs={'data-orderid' : True})
# pprint(len(bought_items))
count = 0
for item in bought_items:
count += 1
# pprint('{}.{}'.format(cur_page, count))
try:
info = {}
# 订单在页面上的位置 页数.排序号
info['pos'] = '{}.{}'.format(cur_page, count)
info['orderid'] = item.attrs['data-orderid']
info['status'] = item.attrs['data-status']
# 店铺
node = item.select('tr.order-hd a.shopname')
if not node:
# 店铺不存在,可能是赠送彩票订单,忽略
# print('ignore')
continue
info['shop_name'] = node[0].attrs['title'].strip()
info['shop_url'] = node[0].attrs['href']
# 日期
node = item.select('tr.order-hd span.dealtime')[0]
info['date'] = datetime.strptime(node.attrs['title'], '%Y-%m-%d %H:%M')
if end_date and info['date'].toordinal() > end_date.toordinal():
continue
if start_date and info['date'].toordinal() < start_date.toordinal():
out_date = True
break
# 宝贝
baobei = []
node = item.find_all('tr', class_='order-bd')
# pprint(len(node))
for n in node:
try:
bb = {}
if [True for ex in extra_service if ex in n.attrs['class']]:
# 额外服务处理
# print('额外服务处理')
name_node = n.find('td', class_='baobei')
# 宝贝地址
bb['name'] = name_node.text.strip()
bb['url'] = ''
bb['spec'] = ''
# 宝贝快照
bb['snapshot'] = ''
# 宝贝价格
bb['price'] = 0.0
# 宝贝数量
bb['quantity'] = 1
bb['is_goods'] = False
try:
bb['url'] = name_node.find('a').attrs['href']
bb['price'] = float(n.find('td',