

本文有两个目的: 一是讲述实现计算机语言解释器的通用方法,另外一点,着重展示如何使用Python来实现Lisp方言Scheme的一个子集。我将我的解释器称之为Lispy (lis.py)。几年前,我介绍过如何使用Java编写一个Scheme解释器,同时我还使用Common Lisp语言编写过一个版本。这一次,我的目的是尽可能简单明了地演示一下Alan Kay所说的“软件的麦克斯韦方程组” (Maxwell's Equations of Software)。
Lispy支持的Scheme子集的语法和语义
大多数计算机语言都有许多语法规约 (例如关键字、中缀操作符、括号、操作符优先级、点标记、分号等等),但是,作为Lisp语言家族中的一员,Scheme所有的语法都是基于包含在括号中的、采用前缀表示的列表的。这种表示看起来似乎有些陌生,但是它具有简单一致的优点。 (一些人戏称”Lisp”是”Lots of Irritating Silly Parentheses“——“大量恼人、愚蠢的括号“——的缩写;我认为它是”Lisp Is Syntactically Pure“——“Lisp语法纯粹”的缩写。) 考虑下面这个例子:
/* Java */
if(x.val() > 0) {
 z = f(a*x.val() + b);
}
/* Scheme */
(if (> (val x) 0)
 (set! z (f (+ (* a (val x)) b))))
</div>
注意上面的惊叹号在Scheme中并不是一个特殊字符;它只是”set!“这个名字的一部分。(在Scheme中)只有括号是特殊字符。类似于(set! x y)这样以特殊关键字开头的列表在Scheme中被称为一个特殊形式 (special form);Scheme的优美之处就在于我们只需要六种特殊形式,以及另外的三种语法构造——变量、常量和过程调用。
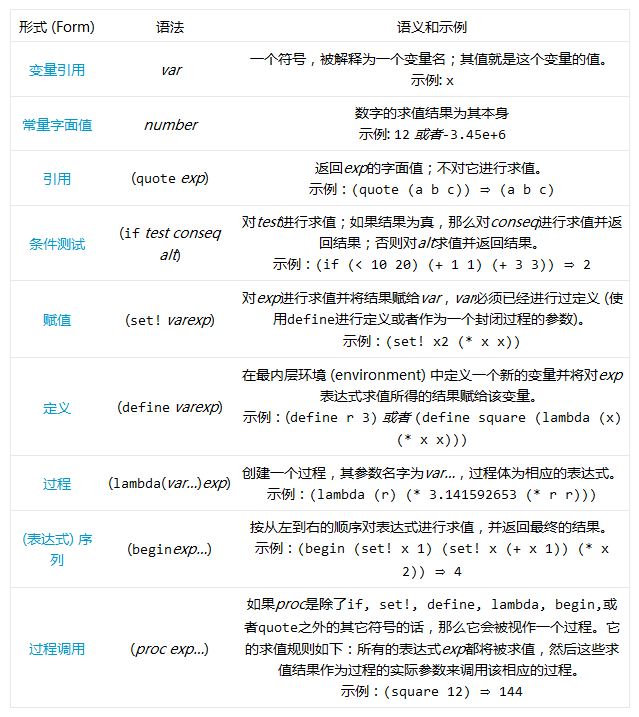
在该表中,var必须是一个符号——一个类似于x或者square这样的标识符——number必须是一个整型或者浮点型数字,其余用斜体标识的单词可以是任何表达式。exp…表示exp的0次或者多次重复。
更多关于Scheme的内容,可以参考一些优秀的书籍 (如Friedman和Fellesein, Dybvig,Queinnec, Harvey和Wright或者Sussman和Abelson)、视频 (Abelson和Sussman)、教程 (Dorai、PLT或者Neller)、或者参考手册。
语言解释器的职责
一个语言解释器包括两部分:
1、解析 (Parsing):解析部分接受一个使用字符序列表示的输入程序,根据语言的语法规则对输入程序进行验证,然后将程序翻译成一种中间表示。在一个简单的解释器中,中间表示是一种树结构,紧密地反映了源程序中语句或表达式的嵌套结构。在一种称为编译器的语言翻译器中,内部表示是一系列可以直接由计算机 (作者的原意是想说运行时系统——译者注) 执行的指令。正如Steve Yegge所说,“如果你不明白编译器的工作方式,那么你不会明白计算机的工作方式。”Yegge介绍了编译器可以解决的8种问题 (或者解释器,又或者采用Yegge的典型的反讽式的解决方案)。 Lispy的解析器由parse函数实现。
2、执行:程序的内部表示 (由解释器) 根据语言的语义规则进行进一步处理,进而执行源程序的实际运算。(Lispy的)执行部分由eval函数实现 (注意,该函数覆盖了Python内建的同名函数)。
下面的图片描述了解释器的解释流程,(图片后的) 交互会话展示了parse和eval函数对一个小程序的操作方式:
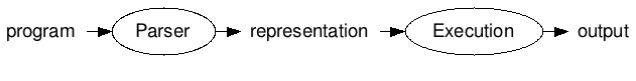
这里,我们采用了一种尽可能简单的内部表示,其中Scheme的列表、数字和符号分别使用Python的列表、数字和字符串来表示。
执行: eval
下面是eval函数的定义。对于上面表中列出的九种情况,每一种都有一至三行代码,eval函数的定义只需要这九种情况:
def eval(x, env=global_env):
 "Evaluate an expression in an environment."
 if isa(x, Symbol):    # variable reference
  return env.find(x)[x]
 elif not isa(x, list):   # constant literal
  return x
 elif x[0] == 'quote':   # (quote exp)
  (_, exp) = x
  return exp
 elif x[0] == 'if':    # (if test conseq alt)
  (_, test, conseq, alt) = x
  return eval((conseq if eval(test, env) else alt), env)
 elif x[0] == 'set!':   # (set! var exp)
  (_, var, exp) = x
  env.find(var)[var] = eval(exp, env)
 elif x[0] == 'define':   # (define var exp)
  (_, var, exp) = x
  env[var] = eval(exp, env)
 elif x[0] == 'lambda':   # (lambda (var*) exp)
  (_, vars, exp) = x
  return lambda *args: eval(exp, Env(vars, args, env))
 elif x[0] == 'begin':   # (begin exp*)
  for exp in x[1:]:
   val = eval(exp, env)
  return val
 else:       # (proc exp*)
  exps = [eval(exp, env) for exp in x]
  proc = exps.pop(0)
  return proc(*exps)

isa = isinstance

Symbol = str
</div>
eval函数的定义就是这么多…当然,除了environments。Environments (环境) 只是从符号到符号所代表的值的映射而已。一个新的符号/值绑定由一个define语句或者一个过程定义 (lambda表达式) 添加。
让我们通过一个例子来观察定义然后调用一个Scheme过程的时候所发生的事情 (lis.py>提示符表示我们正在与Lisp解释器进行交互,而不是Python):
lis.py> (define area (lambda (r) (* 3.141592653 (* r r))))
lis.py> (area 3)
28.274333877
</div>
当我们对(lambda (r) (* 3.141592653 (* r r)))进行求值时,我们在eval函数中执行elif x[0] == 'lambda'分支,将(_, vars, exp)三个变量分别赋值为列表x的对应元素 (如果x的长度不是3,就抛出一个错误)。然后,我们创建一个新的过程,当该过程被调用的时候,将会对表达式['*', 3.141592653 ['*', 'r', 'r']]进行求值,该求值过程的环境 (environment) 是通过将过程的形式参数 (该例中只有一个参数,r) 绑定为过程调用时所提供的实际参数,外加当前环境中所有不在参数列表 (例如,变量*) 的变量组成的。新创建的过程被赋值给global_env中的area变量。
那么,当我们对(area 3)求值的时候发生了什么呢?因为area并不是任何表示特殊形式的符号之一,它必定是一个过程调用 (eval函数的最后一个else:分支),因此整个表达式列表都将会被求值,每次求值其中的一个。对area进行求值将会获得我们刚刚创建的过程;对3进行求值所得的结果就是3。然后我们 (根据eval函数的最后一行) 使用参数列表[3]来调用这个新创建的过程。也就是说,对exp(也就是['*', 3.141592653 ['*', 'r', 'r']])进行求值,并且求值所在的环境中r的值是3,并且外部环境是全局环境,因此*是乘法过程。
现在,我们可以解释一下Env类的细节了:
class Env(dict):
 "An environment: a dict of {'var':val} pairs, with an outer Env."
 def __init__(self, parms=(), args=(), outer=None):
  self.update(zip(parms,args))
  self.outer = outer
 def find(self, var):
  "Find the innermost Env where var appears."
  return self if var in self else self.outer.find(var)
</div>
注意Env是dict的一个子类,也就是说,通常的字典操作也适用于Env类。除此之外,该类还有两个方法,构造函数__init__和find函数,后者用来为一个变量查找正确的环境。理解这个类的关键 (以及我们需要一个类,而不是仅仅使用dict的根本原因) 在于外部环境 (outer environment) 这个概念。考虑下面这个程序: