

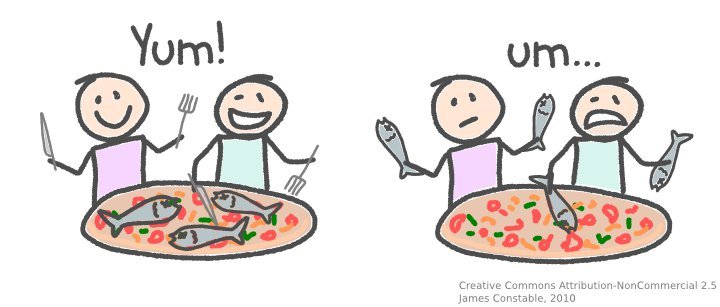
语法分析器描述了一个句子的语法结构,用来帮助其他的应用进行推理。自然语言引入了很多意外的歧义,以我们对世界的了解可以迅速地发现这些歧义。举一个我很喜欢的例子:
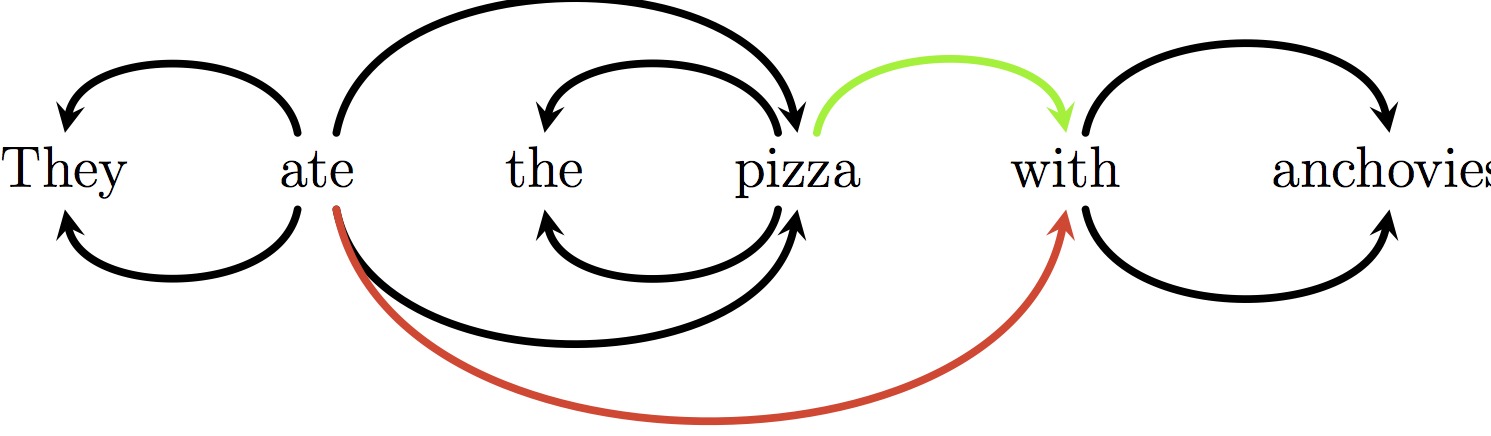
正确的解析是连接“with”和“pizza”,而错误的解析将“with”和“eat”联系在了一起:
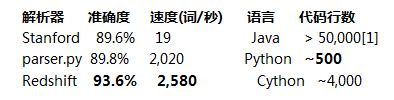
过去的一些年,自然语言处理(NLP)社区在语法分析方面取得了很大的进展。现在,小小的 Python 实现可能比广泛应用的 Stanford 解析器表现得更出色。
文章剩下的部分首先设置了问题,接着带你了解为此准备的简洁实现。parser.py 代码中的前 200 行描述了词性的标注者和学习者(这里)。除非你非常熟悉 NLP 方向的研究,否则在研究这篇文章之前至少应该略读。
Cython 系统和 Redshift 是为我目前的研究而写的。和麦考瑞大学的合同到期后,我计划六月份对它进行改进,用于一般用途。目前的版本托管在 GitHub 上。
问题描述
在你的手机中输入这样一条指令是非常友善的:
Set volume to zero when I'm in a meeting, unless John's school calls.
接着进行适当的策略配置。在 Android 系统上,你可以应用 Tasker 做这样的事情,而 NL 接口会更好一些。接收可以编辑的语义表示,你就能了解到它认为你表达的意思,并且可以修正他的想法,这样是特别友善的。
这项工作有很多问题需要解决,但一些种类的句法形态绝对是必要的。我们需要知道:
Unless John's school calls, when I'm in a meeting, set volume to zero
是解析指令的又一种方式,而
Unless John's school, call when I'm in a meeting
表达了完全不同的意思。
依赖解析器返回一个单词与单词间的关系图,使推理变得更容易。关系图是树形结构,有向边,每个节点(单词)有且仅有一个入弧(头部依赖)。
用法示例:
>>> parser = parser.Parser()
>>> tokens = "Set the volume to zero when I 'm in a meeting unless John 's school calls".split()
>>> tags, heads = parser.parse(tokens)
>>> heads
[-1, 2, 0, 0, 3, 0, 7, 5, 7, 10, 8, 0, 13, 15, 15, 11]
>>> for i, h in enumerate(heads):
...  head = tokens[heads[h]] if h >= 1 else 'None'
...  print(tokens[i] + ' <-- ' + head])
Set <-- None
the <-- volume
volume <-- Set
to <-- Set
zero <-- to
when <-- Set
I <-- 'm
'm <-- when
in <-- 'm
a <-- meeting
meeting <-- in
unless <-- Set
John <-- 's
's  <-- calls
school <-- calls
calls <-- unless
</div>
一种观点是通过语法分析进行推导比字符串应该稍稍容易一些。语义分析映射有望比字面意义映射更简单。
这个问题最让人困惑的是正确性是由惯例,即注释指南决定的。如果你没有阅读指南并且不是一个语言学家,就不能判断解析是否正确,这使整个任务显得奇怪和虚假。
例如,在上面的解析中存在一个错误:根据 Stanford 的注释指南规定,“John's school calls” 存在结构错误。而句子这部分的结构是指导注释器如何解析一个类似于“John's school clothes”的例子。
这一点值得深入考虑。理论上讲,我们已经制定了准则,所以“正确”的解析应该相反。如果我们违反约定,有充分的理由相信解析任务会变得更加困难,因为任务和其他语>法的一致性会降低。【2】但是我们可以测试经验,并且我们很高兴通过反转策略获得优势。
我们确实需要惯例中的差异——我们不希望接收相同的结构,否则结果不会很有用。注释指南在哪些区别使下游应用有效和哪些解析器可以轻松预测之间取得平衡。
映射树
在决定构建什么样子的关系图时,我们可以进行一项特别有效的简化:对将要处理的关系图结构进行限制。它不仅在易学性方面有优势,在加深算法理解方面也有作用。大部分的>英文解析工作中,我们遵循约束的依赖关系图就是映射树:
树。除了根外,每个单词都有一个弧头。
映射关系。针对每对依赖关系 (a1, a2)和 (b1, b2),如果 a1 < b2, 那么 a2 >= b2。换句话说,依赖关系不能交叉。不可能存在一对 a1 b1 a2 b2 或者 b1 a1 b2 a2 形式的依赖关系。
在解析非映射树方面有丰富的文献,解析无环有向图方面的文献相对而言少一些。我将要阐述的解析算法用于映射树领域。
贪婪的基于转换的解析
我们的语法分析器以字符串符号列表作为输入,输出代表关系图中边的弧头索引列表。如果第 i 个弧头元素是 j, 依赖关系包括一条边 (j, i)。基于转换的语法分析器>是有限状态转换器;它将 N 个单词的数组映射到 N 个弧头索引的输出数组。
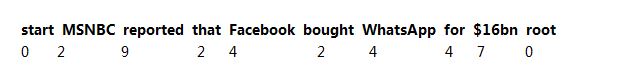
弧头数组表示了 MSNBC 的弧头:MSNBC 的单词索引是1,reported 的单词索引是2, head[1] == 2。你应该已经发现为什么树形结构如此方便——如果我们输出一个 DAG 结构,这种结构中的单词可能包含多个弧头,树形结构将不再工作。
虽然 heads 可以表示为一个数组,我们确实喜欢保持一定的替代方式来访问解析,以方便高效的提取特征。Parse 类就是这样:
class Parse(object):
  def __init__(self, n):
    self.n = n
    self.heads = [None] * (n-1)
    self.lefts = []
    self.rights = []
    for i in range(n+1):
      self.lefts.append(DefaultList(0))
      self.rights.append(DefaultList(0))

  def add_arc(self, head, child):
    self.heads[child] = head
    if child < head:
      self.lefts[head].append(child)
    else:
      self.rights[head].append(child)
</div>
和语法解析一样,我们也需要跟踪句子中的位置。我们通过在 words 数组中置入一个索引和引入栈机制实现,栈中可以压入单词,设置单词的弧头时,弹出单词。所以我们的状态数据结构是基础。
- 一个索引 i, 活动于符号列表中
- 到现在为止语法解析器中的加入的依赖关系
- 一个包含索引 i 之前产生的单词的栈,我们已为这些单词声明了弧头。
解析过程的每一步都应用了三种操作之一:
SHIFT = 0; RIGHT = 1; LEFT = 2
MOVES = [SHIFT, RIGHT, LEFT]

def transition(move, i, stack, parse):
  global SHIFT, RIGHT, LEFT
  if move == SHIFT:
    stack.append(i)
    return i + 1
  elif move == RIGHT:
    parse.add_arc(stack[-2], stack.pop())
    return i
  elif move == LEFT:
    parse.add_arc(i, stack.pop())
    return i
  raise GrammarError("Unknown move: %d" % move)
</div>
LEFT 和 RIGHT 操作添加依赖关系并弹栈,而 SHIFT 压栈并增加缓存中 i 值。
因此,语法解析器以一个空栈开始,缓存索引为0,没有依赖关系记录。选择一个有效的操作,应用到当前状态。继续选择操作并应用直到栈为空且缓存索引到达输入数组的终点。(没有逐步跟踪是很难理解这种算法的。尝试准备一个句子,画出映射解析树,接着通过选择正确的转换序列遍历完解析树。)
下面是代码中的解析循环:
class Parser(object):
  ...
  def parse(self, words):
    tags = self.tagger(words)
    n = len(words)
    idx = 1
    stack = [0]
    deps = Parse(n)
    while stack or idx < n:
      features = extract_features(words, tags, idx, n, stack, deps)
      scores = self.model.score(features)
      valid_moves = get_valid_moves(i, n, len(stack))
      next_move = max(valid_moves, key=lambda move: scores[move])
      idx = transition(next_move, idx, stack, parse)
    return tags, parse

def get_valid_moves(i, n, stack_depth):
  moves = []
  if i < n:
    moves.append(SHIFT)
  if stack_depth >= 2:
    moves.append(RIGHT)
  if stack_depth >= 1:
    moves.append(LEFT)
  return moves
</div>
我们以标记的句子开始,