
• linkedu视频
  • 平面设计
  • 电脑入门
  • 操作系统
  • 办公应用
  • 电脑硬件
  • 动画设计
  • 3D设计
  • 网页设计
  • CAD设计
  • 影音处理
  • 数据库
  • 程序设计
  • 认证考试
  • 信息管理
  • 信息安全
菜单
linkedu.com
  • 网页制作
  • 数据库
  • 程序设计
  • 操作系统
  • CMS教程
  • 游戏攻略
  • 脚本语言
  • 平面设计
  • 软件教程
  • 网络安全
  • 电脑知识
  • 服务器
  • 视频教程
  • vbs
  • DOS/BAT
  • hta/htc
  • python
  • perl
  • VBA
  • ColdFusion
  • ruby
  • PowerShell
  • Lua
  • Golang
  • linux shell
您的位置:首页 > 脚本语言 >python > Python实现爬取知乎神回复简单爬虫代码分享

Python实现爬取知乎神回复简单爬虫代码分享

作者:junjie 字体:[增加 减小] 来源:互联网

junjie 通过本文主要向大家介绍了python爬虫知乎,python爬虫,python爬虫入门教程,python爬虫教程,python网络爬虫等相关知识,希望对您有所帮助,也希望大家支持linkedu.com www.linkedu.com

看知乎的时候发现了一个 “如何正确地吐槽” 收藏夹,里面的一些神回复实在很搞笑,但是一页一页地看又有点麻烦,而且每次都要打开网页,于是想如果全部爬下来到一个文件里面,是不是看起来很爽,并且随时可以看到全部的,于是就开始动手了。

工具

1.Python 2.7
2.BeautifulSoup

分析网页

我们先来看看知乎上该网页的情况

网址:,容易看到,网址是有规律的,page慢慢递增,这样就能够实现全部爬取了。

再来看一下我们要爬取的内容:
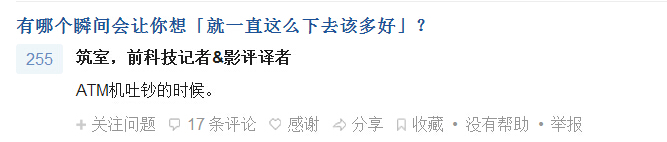
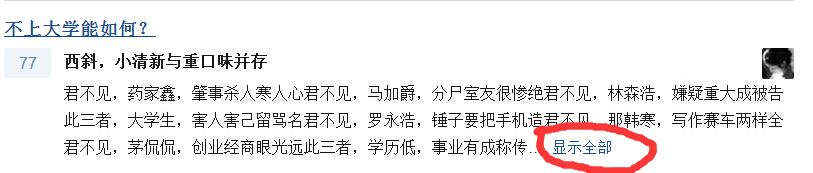
我们要爬取两个内容:问题和回答,回答仅限于显示了全部内容的回答,如下面这种就不能爬取,因为好像无法展开(反正我不会。。),再说答案不全的话爬来也没用,所以就不爬答案不全的了吧。
好,那么下面我们要找到他们在网页源代码中的位置:
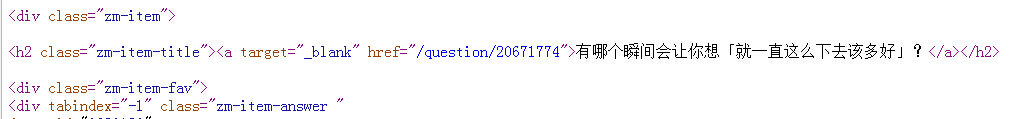
即我们找到问题的内容包含在<h2 class = "zm-item-title"><a tar...>中,那么我们等会就可以在这个标签里面找问题。

然后是回复:
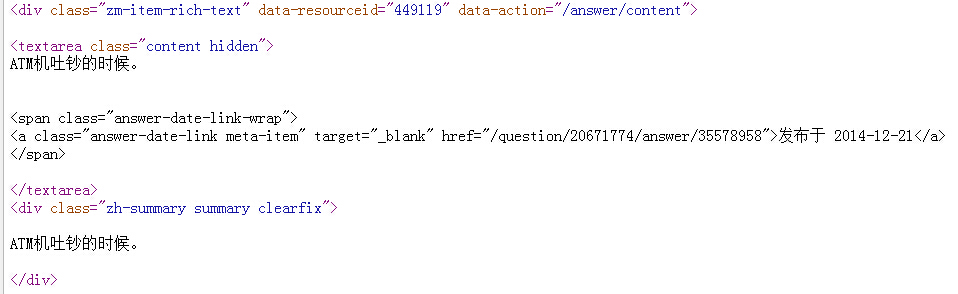
有两个地方都有回复的内容,因为上面那个的内容还包括了<span..>等一些内容,不方便处理,我们爬下面那个的内容,因为那个里面的内容纯正无污染。

代码

好,这时候我们试着写出python代码:
# -*- coding: cp936 -*-
import urllib2
from BeautifulSoup import BeautifulSoup

f = open('howtoTucao.txt','w')     #打开文件

for pagenum in range(1,21):        #从第1页爬到第20页

    strpagenum = str(pagenum)      #页数的str表示
    print "Getting data for Page " + strpagenum   #shell里面显示的,表示已爬到多少页
    url = "http://www.zhihu.com/collection/27109279?page="+strpagenum  #网址
    page = urllib2.urlopen(url)     #打开网页
    soup = BeautifulSoup(page)      #用BeautifulSoup解析网页
   
    #找到具有class属性为下面两个的所有Tag
    ALL = soup.findAll(attrs = {'class' : ['zm-item-title','zh-summary summary clearfix'] })

    for each in ALL :               #枚举所有的问题和回答
        #print type(each.string)
        #print each.name
        if each.name == 'h2' :      #如果Tag为h2类型,说明是问题
            print each.a.string     #问题中还有一个<a..>,所以要each.a.string取出内容
            if each.a.string:       #如果非空,才能写入
                f.write(each.a.string)
            else :                  #否则写"No Answer"
                f.write("No Answer")
        else :                      #如果是回答,同样写入
            print each.string
            if each.string:
                f.write(each.string)
            else :
                f.write("No Answer")
f.close()                           #关闭文件
</div>

代码虽然不常,可是写了我半天,开始各种出问题。

运行

然后我们运行就可以爬了:
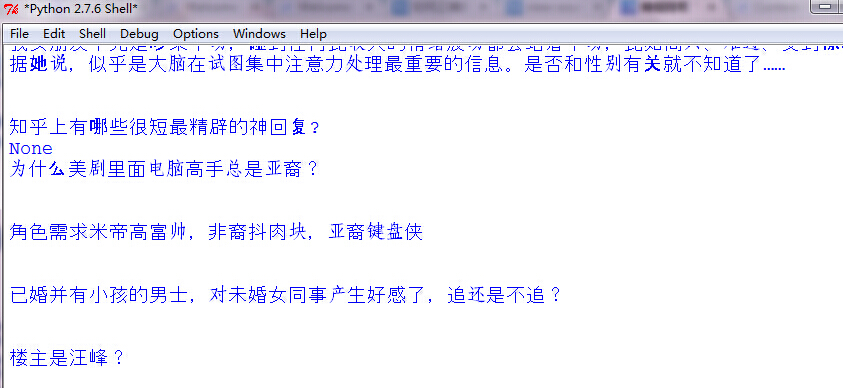
结果

等运行完毕,我们打开文件howtoTucao.txt,可以看到,这样就爬取成功了。只是格式可能还是有点问题,原来是我No Answer没加换行,所以No Answer还会混到文本里面去,加两个换行就可以了。
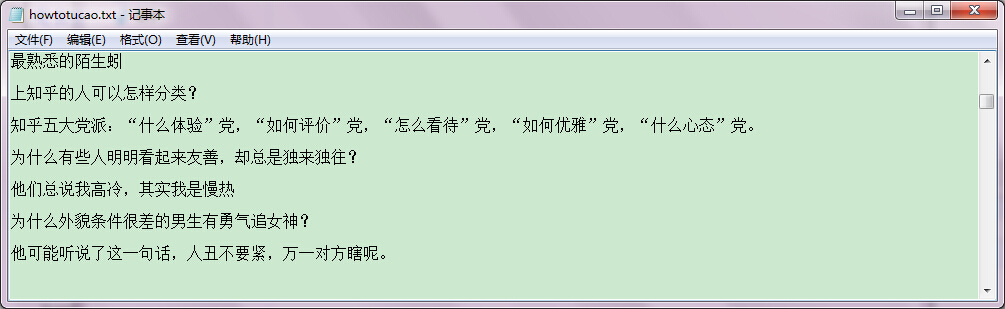
</div>

您可能想查找下面的文章:

  • Python实现爬取知乎神回复简单爬虫代码分享

相关文章

  • Python中使用platform模块获取系统信息的用法教程
  • 一个基于flask的web应用诞生(1)
  • Python通过RabbitMQ服务器实现交换机功能的实例教程
  • python使用点操作符访问字典(dict)数据的方法
  • python检测lvs real server状态
  • python中的__init__ 、__new__、__call__小结
  • Python实现单词拼写检查
  • 使用tensorboard可视化loss和acc的实例
  • Python正则表达式教程之一:基础篇
  • Python 包含汉字的文件读写之每行末尾加上特定字符

文章分类

  • vbs
  • DOS/BAT
  • hta/htc
  • python
  • perl
  • VBA
  • ColdFusion
  • ruby
  • PowerShell
  • Lua
  • Golang
  • linux shell

最近更新的内容

    • python中List的sort方法指南
    • Python安装第三方库及常见问题处理方法汇总
    • 零基础写python爬虫之使用Scrapy框架编写爬虫
    • Django中实现一个高性能计数器(Counter)实例
    • python生成器表达式和列表解析
    • python xml.etree.ElementTree遍历xml所有节点实例详解
    • Python实现简单字典树的方法
    • python爬取本站电子书信息并入库的实现代码
    • Python socket网络编程TCP/IP服务器与客户端通信
    • python实现清屏的方法

关于我们 - 联系我们 - 免责声明 - 网站地图

©2020-2025 All Rights Reserved. linkedu.com 版权所有