

通过本文主要向大家介绍了朴素贝叶斯算法python,python贝叶斯算法,python 朴素贝叶斯,python实现朴素贝叶斯,python 贝叶斯等相关知识,希望对您有所帮助,也希望大家支持linkedu.com www.linkedu.com
这里再重复一下标题为什么是"使用"而不是"实现":
首先,专业人士提供的算法比我们自己写的算法无论是效率还是正确率上都要高。
其次,对于数学不好的人来说,为了实现算法而去研究一堆公式是很痛苦的事情。
再次,除非他人提供的算法满足不了自己的需求,否则没必要"重复造轮子"。
下面言归正传,不了解贝叶斯算法的可以去查一下相关资料,这里只是简单介绍一下:
1.贝叶斯公式:
P(A|B)=P(AB)/P(B)
2.贝叶斯推断:
P(A|B)=P(A)×P(B|A)/P(B)
用文字表述:
后验概率=先验概率×相似度/标准化常量
而贝叶斯算法要解决的问题就是如何求出相似度,即:P(B|A)的值
3. 在scikit-learn包中提供了三种常用的朴素贝叶斯算法,下面依次说明:
1)高斯朴素贝叶斯:假设属性/特征是服从正态分布的(如下图),主要应用于数值型特征。
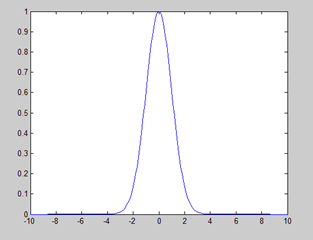
使用scikit-learn包中自带的数据,代码及说明如下:
>>>from sklearn import datasets ##导入包中的数据
>>> iris=datasets.load_iris() ##加载数据
>>> iris.feature_names  ##显示特征名字
 ['sepal length (cm)', 'sepal width (cm)', 'petal length (cm)', 'petal width (cm)']
>>> iris.data   ##显示数据
 array([[ 5.1, 3.5, 1.4, 0.2],[ 4.9, 3. , 1.4, 0.2],[ 4.7, 3.2, 1.3, 0.2]............
>>> iris.data.size  ##数据大小 ---600个
>>> iris.target_names  ##显示分类的名字
 array(['setosa', 'versicolor', 'virginica'], dtype='<U10')
>>> from sklearn.naive_bayes import GaussianNB ##导入高斯朴素贝叶斯算法
>>> clf = GaussianNB()    ##给算法赋一个变量,主要是为了方便使用
>>> clf.fit(iris.data, iris.target)  ##开始分类。对于量特别大的样本,可以使用函数partial_fit分类,避免一次加载过多数据到内存

>>> clf.predict(iris.data[0].reshape(1,-1)) ##验证分类。标红部分特别说明:因为predict的参数是数组,data[0]是列表,所以需要转换一下
array([0])
>>> data=np.array([6,4,6,2])   ##验证分类
>>> clf.predict(data.reshape(1,-1))
array([2])
</div>
这里涉及到一个问题:如何判断数据符合正态分布? R语言里面有相关函数判断,或者直接绘图也可以看出来,但是都是P(x,y)这种可以在坐标系里面直接
画出来的情况,而例子中的数据如何确定,目前还没有搞明白,这部分后续会补上。
2)多项式分布朴素贝叶斯:常用于文本分类,特征是单词,值是单词出现的次数。
##示例来在官方文档,详细说明见第一个例子
>>> import numpy as np
>>> X = np.random.randint(5, size=(6, 100)) ##返回随机整数值:范围[0,5) 大小6*100 6行100列
>>> y = np.array([1, 2, 3, 4, 5, 6])
>>> from sklearn.naive_bayes import MultinomialNB
>>> clf = MultinomialNB()
>>> clf.fit(X, y)
MultinomialNB(alpha=1.0, class_prior=None, fit_prior=True)
>>> print(clf.predict(X[2]))
[3]
</div>
3)伯努力朴素贝叶斯:每个特征都是是布尔型,得出的结果是0或1,即出现没出现
##示例来在官方文档,详细说明见第一个例子
>>> import numpy as np
>>> X = np.random.randint(2, size=(6, 100))
>>> Y = np.array([1, 2, 3, 4, 4, 5])
>>> from sklearn.naive_bayes import BernoulliNB
>>> clf = BernoulliNB()
>>> clf.fit(X, Y)
BernoulliNB(alpha=1.0, binarize=0.0, class_prior=None, fit_prior=True)
>>> print(clf.predict(X[2]))
[3]
</div>
补充说明:此文还不完善,示例一中也有部分说明需要写,最近事情较多,后续会逐渐完善。
以上就是本文的全部内容,希望本文的内容对大家的学习或者工作能带来一定的帮助,同时也希望多多支持!
</div>