

使用python asyncio实现了一个异步代理池,根据规则爬取代理网站上的免费代理,在验证其有效后存入redis中,定期扩展代理的数量并检验池中代理的有效性,移除失效的代理。同时用aiohttp实现了一个server,其他的程序可以通过访问相应的url来从代理池中获取代理。
源码
Github
环境
- Python 3.5+
- Redis
- PhantomJS(可选)
- Supervisord(可选)
因为代码中大量使用了asyncio的async和await语法,它们是在Python3.5中才提供的,所以最好使用Python3.5及以上的版本,我使用的是Python3.6。
依赖
- redis
- aiohttp
- bs4
- lxml
- requests
- selenium
selenium包主要是用来操作PhantomJS的。
下面来对代码进行说明。
1. 爬虫部分
核心代码
async def start(self):
 for rule in self._rules:
 parser = asyncio.ensure_future(self._parse_page(rule)) # 根据规则解析页面来获取代理
 logger.debug('{0} crawler started'.format(rule.__rule_name__))
 if not rule.use_phantomjs:
  await page_download(ProxyCrawler._url_generator(rule), self._pages, self._stop_flag) # 爬取代理网站的页面
 else:
  await page_download_phantomjs(ProxyCrawler._url_generator(rule), self._pages,
rule.phantomjs_load_flag, self._stop_flag) # 使用PhantomJS爬取
 await self._pages.join()
 parser.cancel()
 logger.debug('{0} crawler finished'.format(rule.__rule_name__))
</div>
上面的核心代码实际上是一个用asyncio.Queue实现的生产-消费者模型,下面是该模型的一个简单实现:
import asyncio
from random import random
async def produce(queue, n):
 for x in range(1, n + 1):
 print('produce ', x)
 await asyncio.sleep(random())
 await queue.put(x) # 向queue中放入item
async def consume(queue):
 while 1:
 item = await queue.get() # 等待从queue中获取item
 print('consume ', item)
 await asyncio.sleep(random())
 queue.task_done() # 通知queue当前item处理完毕
async def run(n):
 queue = asyncio.Queue()
 consumer = asyncio.ensure_future(consume(queue))
 await produce(queue, n) # 等待生产者结束
 await queue.join() # 阻塞直到queue不为空
 consumer.cancel() # 取消消费者任务,否则它会一直阻塞在get方法处
def aio_queue_run(n):
 loop = asyncio.get_event_loop()
 try:
 loop.run_until_complete(run(n)) # 持续运行event loop直到任务run(n)结束
 finally:
 loop.close()
if __name__ == '__main__':
 aio_queue_run(5)
</div>
运行上面的代码,一种可能的输出如下:
produce 1
produce 2
consume 1
produce 3
produce 4
consume 2
produce 5
consume 3
consume 4
consume 5
</div>
爬取页面
async def page_download(urls, pages, flag):
 url_generator = urls
 async with aiohttp.ClientSession() as session:
 for url in url_generator:
  if flag.is_set():
  break
  await asyncio.sleep(uniform(delay - 0.5, delay + 1))
  logger.debug('crawling proxy web page {0}'.format(url))
  try:
  async with session.get(url, headers=headers, timeout=10) as response:
   page = await response.text()
   parsed = html.fromstring(decode_html(page)) # 使用bs4来辅助lxml解码网页:http://lxml.de/elementsoup.html#Using only the encoding detection
   await pages.put(parsed)
   url_generator.send(parsed) # 根据当前页面来获取下一页的地址
  except StopIteration:
  break
  except asyncio.TimeoutError:
  logger.error('crawling {0} timeout'.format(url))
  continue # TODO: use a proxy
  except Exception as e:
  logger.error(e)
</div>
使用aiohttp实现的网页爬取函数,大部分代理网站都可以使用上面的方法来爬取,对于使用js动态生成页面的网站可以使用selenium控制PhantomJS来爬取——本项目对爬虫的效率要求不高,代理网站的更新频率是有限的,不需要频繁的爬取,完全可以使用PhantomJS。
解析代理
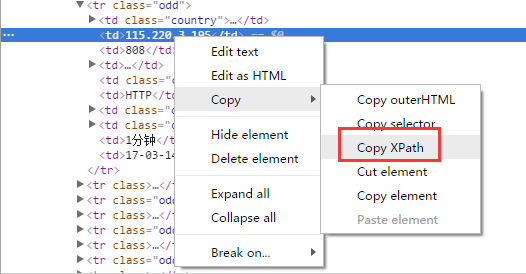
最简单的莫过于用xpath来解析代理了,使用Chrome浏览器的话,直接通过右键就能获得选中的页面元素的xpath:
安装Chrome的扩展“XPath Helper”就可以直接在页面上运行和调试xpath,十分方便:
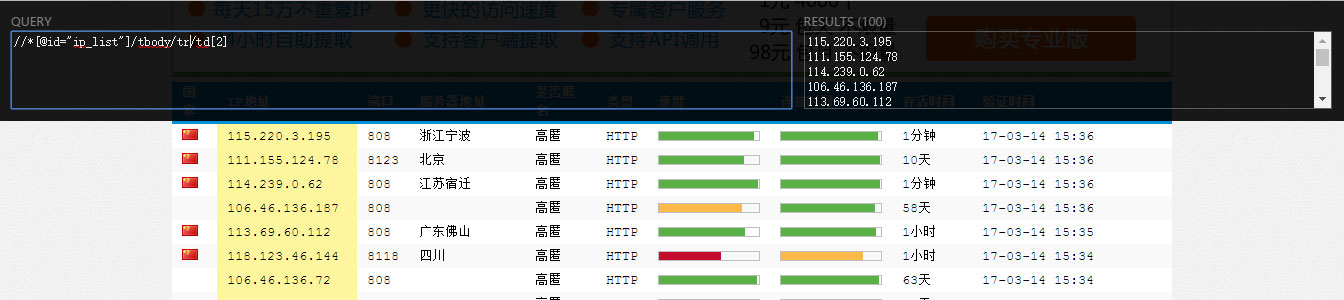
BeautifulSoup不支持xpath,使用lxml来解析页面,代码如下:
async def _parse_proxy(self, rule, page):
 ips = page.xpath(rule.ip_xpath) # 根据xpath解析得到list类型的ip地址集合
 ports = page.xpath(rule.port_xpath) # 根据xpath解析得到list类型的ip地址集合
 if not ips or not ports:
 logger.warning('{2} crawler could not get ip(len={0}) or port(len={1}), please check the xpaths or network'.
  format(len(ips), len(ports), rule.__rule_name__))
 return
 proxies = map(lambda x, y: '{0}:{1}'.format(x.text.strip(), y.text.strip()), ips, ports)
 if rule.filters: # 根据过滤字段来过滤代理,如“高匿”、“透明”等
 filters = []
 for i, ft in enumerate(rule.filters_xpath):
  field = page.xpath(ft)
  if not field:
  logger.warning('{1} crawler could not get {0} field, please check the filter xpath'.
   format(rule.filters[i], rule.__rule_name__))
  continue
  filters.append(map(lambda x: x.text.strip(), field))
 filters = zip(*filters)
 selector = map(lambda x: x == rule.filters, filters)
 proxies = compress(proxies, selector)
for proxy in proxies:
await self._proxies.put(proxy) # 解析后的代理放入asyncio.Queue中
</div>
爬虫规则
网站爬取、代理解析、滤等等操作的规则都是由各个代理网站的规则类定义的,使用元类和基类来管理规则类。基类定义如下:
class CrawlerRuleBase(object, metaclass=CrawlerRuleMeta):
 start_url = None
 page_count = 0
 urls_format = None
 next_page_xpath = None
 next_page_host = ''
 use_phantomjs = False
 phantomjs_load_flag = None
 filters = ()
 ip_xpath = None
 port_xpath = None
 filters_xpath = ()
</div>
各个参数的含义如下:
start_url(必需)
爬虫的起始页面。
ip_xpath(必需)
爬取IP的xpath规则。
port_xpath(必需)
爬取端口号的xpath规则。
page_count
爬取的页面数量。
urls_format
页面地址的格式字符串,通过urls_format.format(start_url, n)来生成第n页的地址,这是比较常见的页面地址格式。
next_page_xpath,next_page_host
由xpath规则来获取下一页的url(常见的是相对路径),结合host得到下一页的地址:next_page_host + url。
use_phantomjs, phantomjs_load_flag
use_phantomjs用于标识爬取该网站是否需要使用PhantomJS,若使用,需定义phantomjs_load_flag(网页上的某个元素,str类型)作为PhantomJS页面加载完毕的标志。
filters
过滤字段集合,可迭代类型。用于过滤代理。
爬取各个过滤字段的xpath规则,与过滤字段按顺序一一对应。
元类CrawlerRuleMeta用于管理规则类的定义,如:如果定义use_phantomjs=True,则必须定义phantomjs_load_flag,否则会抛出异常,不在此赘述。
目前已经实现的规则有西刺代理、快代理、360代理、66代理和 秘密代理。新增规则类也很简单,通过继承CrawlerRuleBase来定义新的规则类YourRuleClass,放在proxypool/rules目录下,并在该目录下的__init__.py中添加from . import YourRuleClass(这样通过CrawlerRuleBase.__subclasses__()就可以获取全部的规则类了),重启正在运行的proxy pool即可应用新的规则。
2. 检验部分
免费的代理虽然多,但是可用的却不